
ヒントとベストプラクティス
Drylab での scRNA-seq ワークフロー
GSE162631(膠芽腫の scRNA-seq)を、10x の生カウントからアノテーション済みクラスターまで、各ステップで使った実際のプロンプトとともに解説します。
GSE162631(膠芽腫の scRNA-seq)を、10x の生カウントからアノテーション済みのクラスターまで通しで解説します。各ステップで実際に使ったプロンプトも紹介します。
ステージ 1:準備
何かを実行する前に、適切なワークフローを見つけ、必要な情報をしっかり伝えます。
1. ワークフローを探す:@scrna で検索
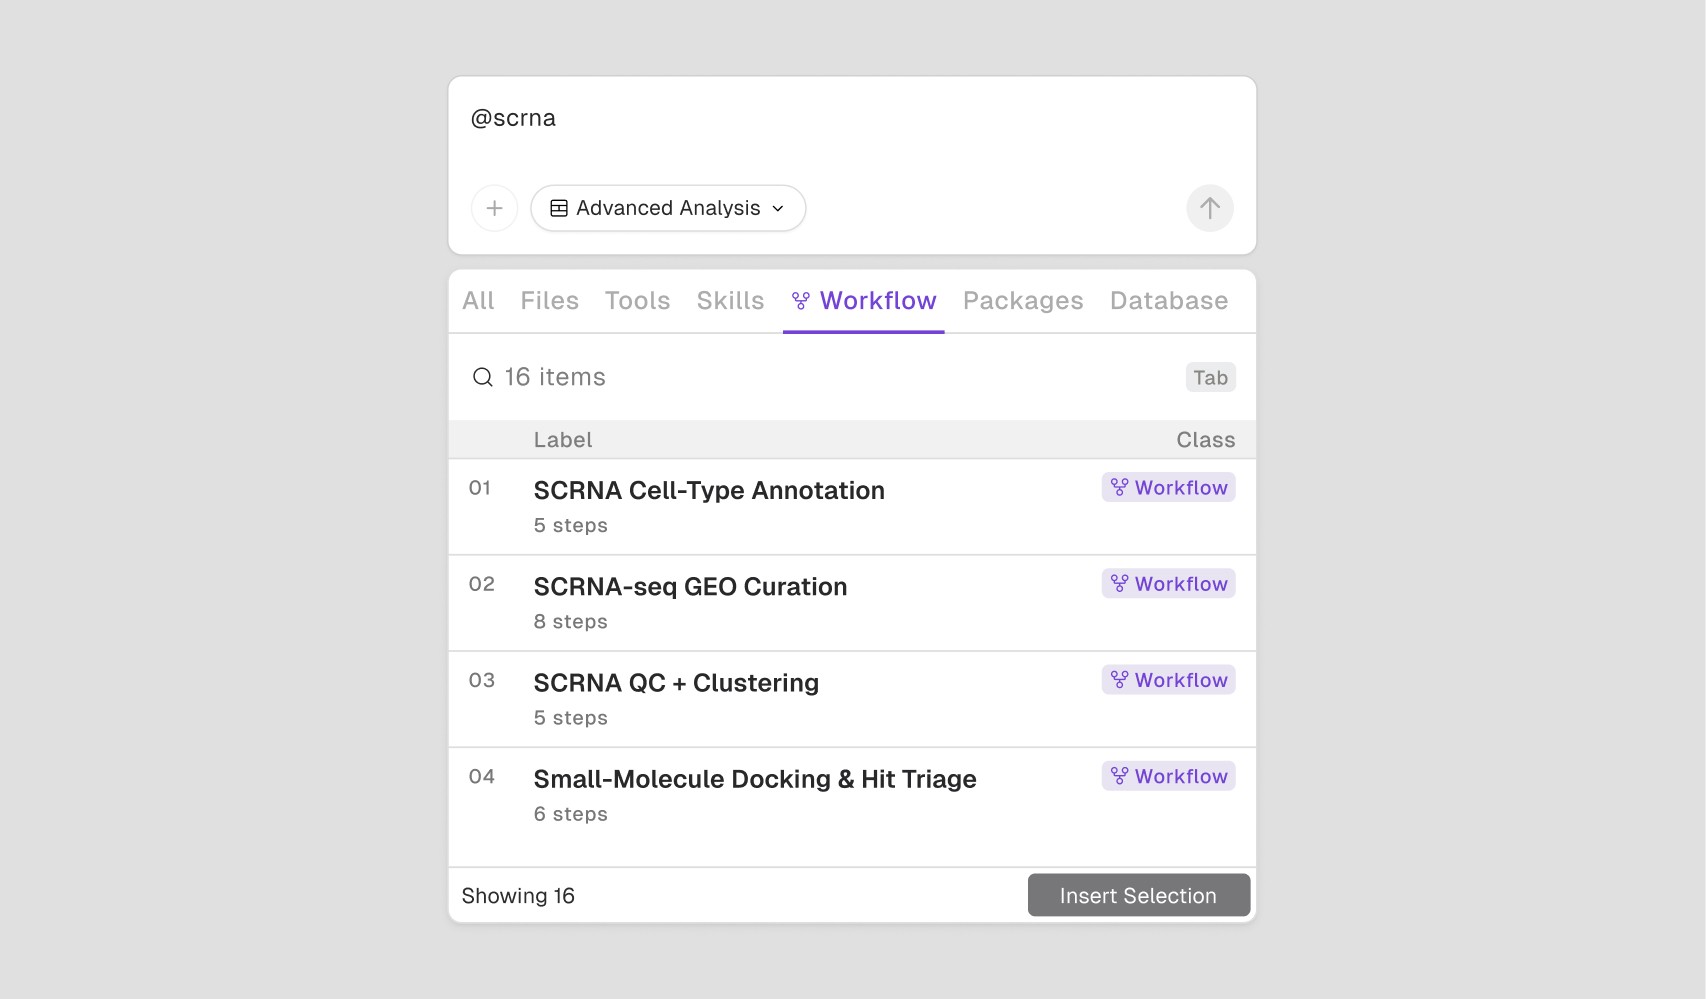
新しいチャットで @scrna と入力します。Drylab がシングルセル向けのワークフローに絞り込みます:scRNA Cell-Type Annotation、scRNA QC + Clustering、Spatial Domain Detection & Annotation。このガイドでは、まず scRNA QC + Clustering を使い、その後 scRNA Cell-Type Annotation につなげます。
2. プレビューする:番号付きのステップとタグを確認
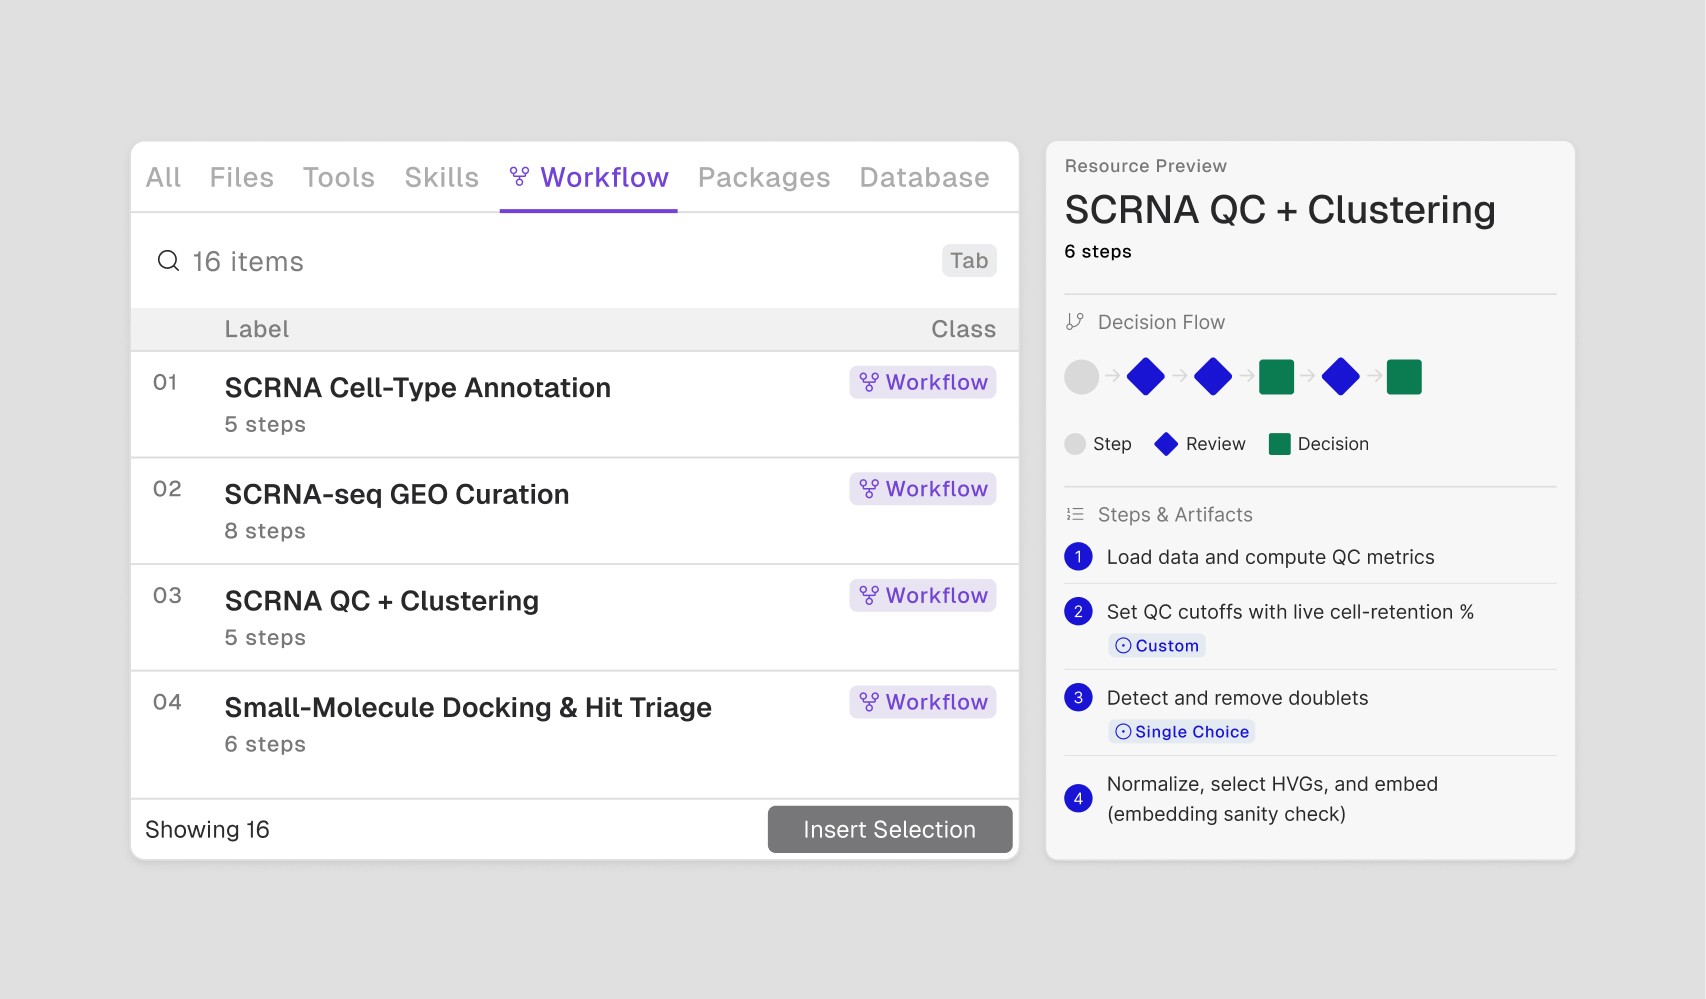
選択する前に、リソースのプレビューをスクロールして確認します。scRNA QC + Clustering は 6 つのステップで構成されています:(1) Load data and compute QC metrics(データを読み込み QC 指標を計算)、(2) Set QC cutoffs(QC のカットオフを設定)— Custom、(3) Detect and remove doublets(ダブレットを検出して除去)— Single Choice、(4) Normalize, select HVGs, and embed(正規化、高変動遺伝子の選択、埋め込み)— Gating Tree、(5) Choose clustering resolution(クラスタリングの解像度を選択)— Image Choice、(6) Export QC'd + clustered object(QC とクラスタリング済みのオブジェクトをエクスポート)。6 つのうち 4 つのステップで一時停止して入力を求めます。どのステップで、どのように入力するかはタグでわかります。
3. ドキュメントと使用スキルを読む
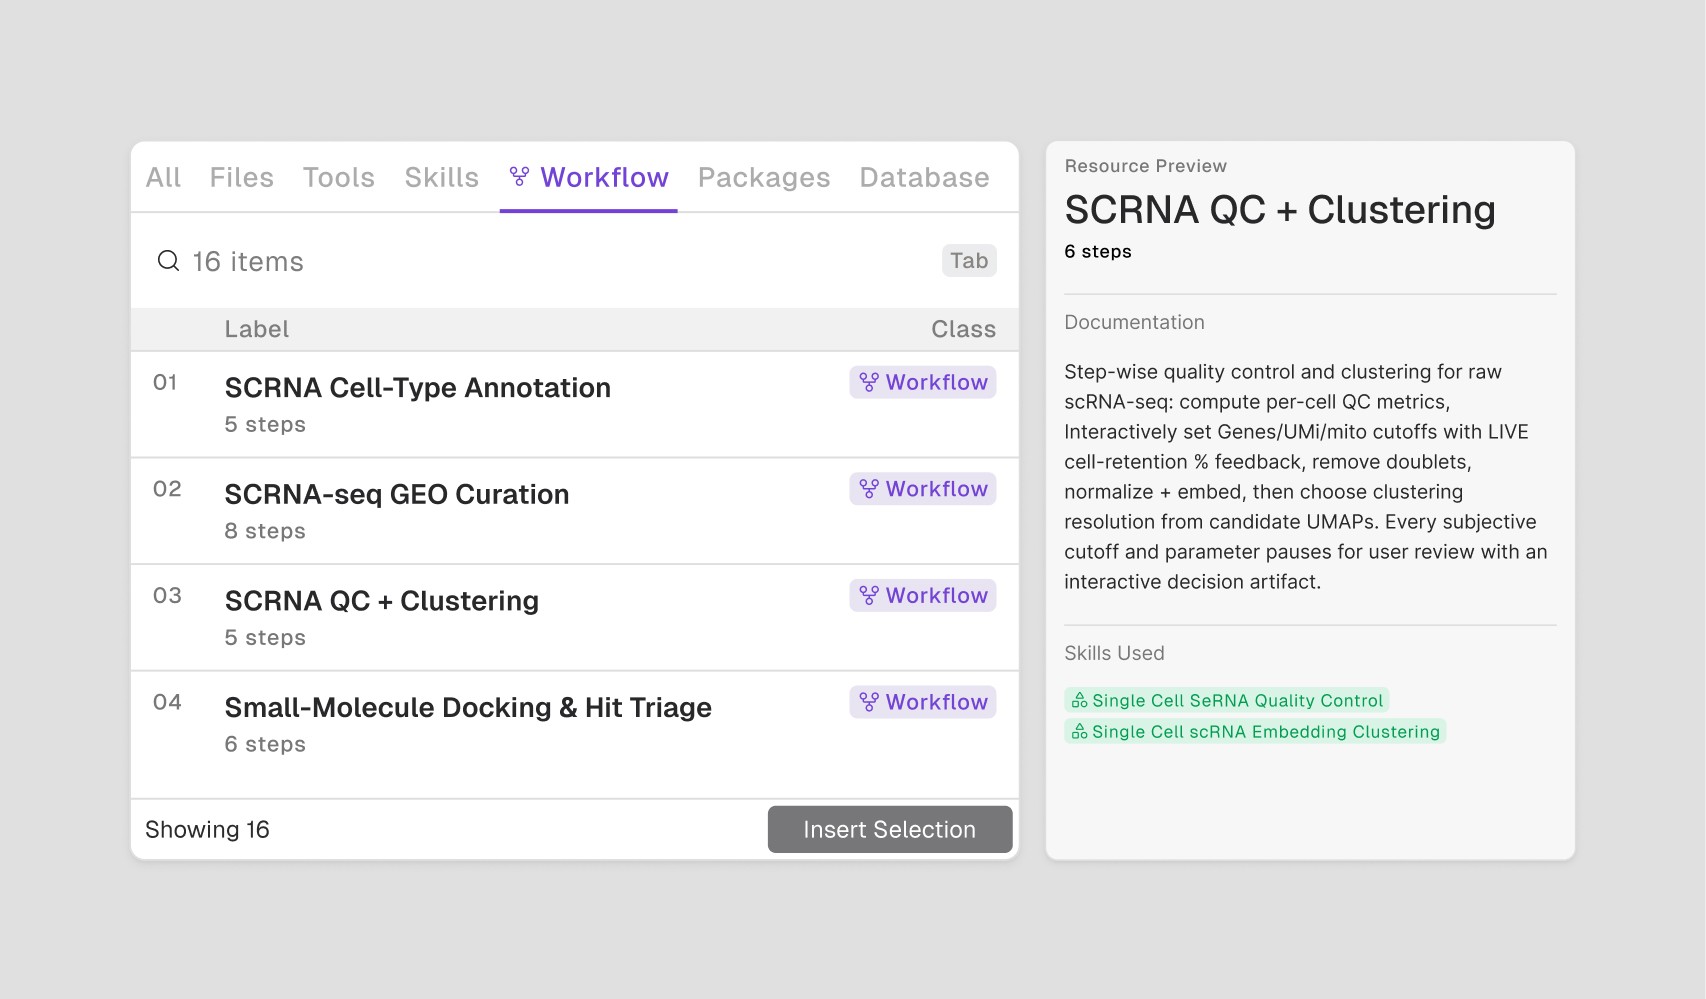
ドキュメントを読めば、これが目的に合ったワークフローだと確認できます:「生の scRNA-seq データに対して段階的に品質管理とクラスタリングを行います。細胞ごとの QC 指標を計算し、細胞の保持率(%)をリアルタイムで確認しながら nGenes/UMI/ミトコンドリアのカットオフを対話的に設定し、ダブレットを除去し、正規化と埋め込みを行ったうえで、候補の UMAP からクラスタリングの解像度を選びます」使用スキルには Single Cell scRNA Quality Control と Single Cell scRNA Embedding Clustering が表示されます。
4. レビューモードを設定する
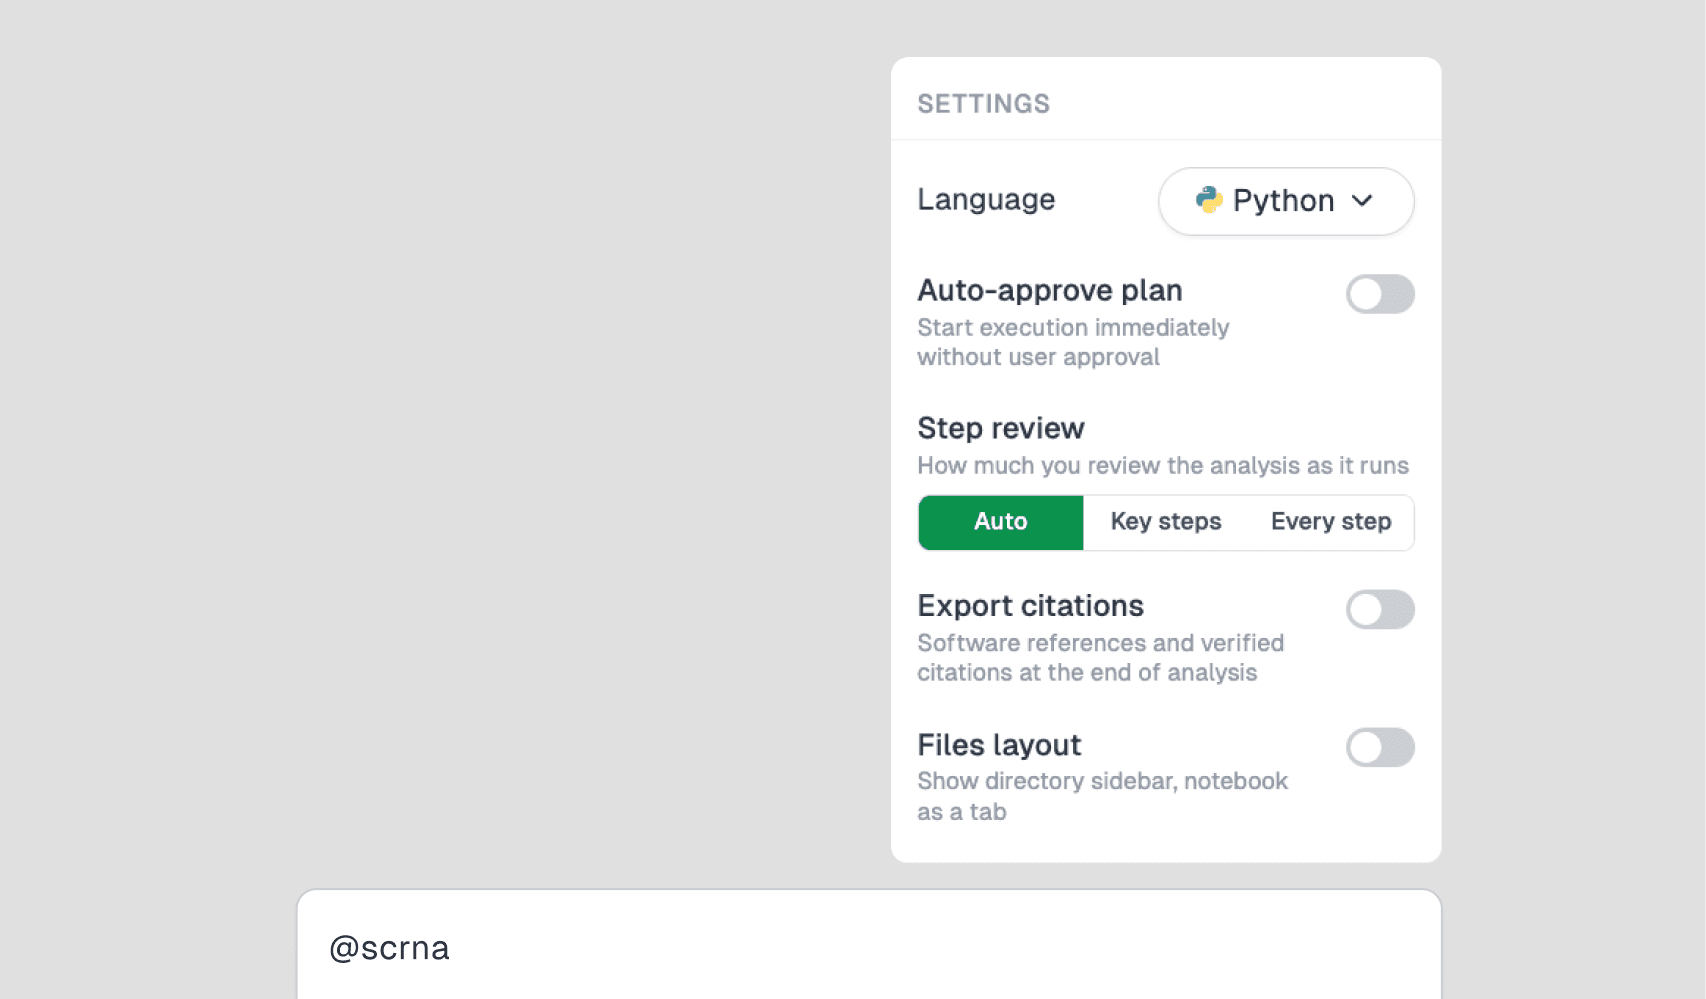
実行設定(チャット欄のモードボタンの横にある歯車)を開きます。ステップレビューには 3 つの選択肢があります:自動(計画を承認したあと全体を実行)、主要ステップ(細胞タイプのアノテーションなど、主観的でリスクの高いステップでのみ一時停止)、毎ステップ。このデータセットで QC + Clustering を初めて実行する場合は、毎ステップを選び、チェックポイントを 1 つずつ確認しましょう。閾値を検証できたら、再実行時には主要ステップや自動に切り替えてもかまいません。実行設定を参照してください。
ステージ 2:QC + クラスタリング
分析を開始し、Drylab が示すチェックポイントを 1 つずつ進めます。
1. 詳細まで指定したプロンプトで開始する
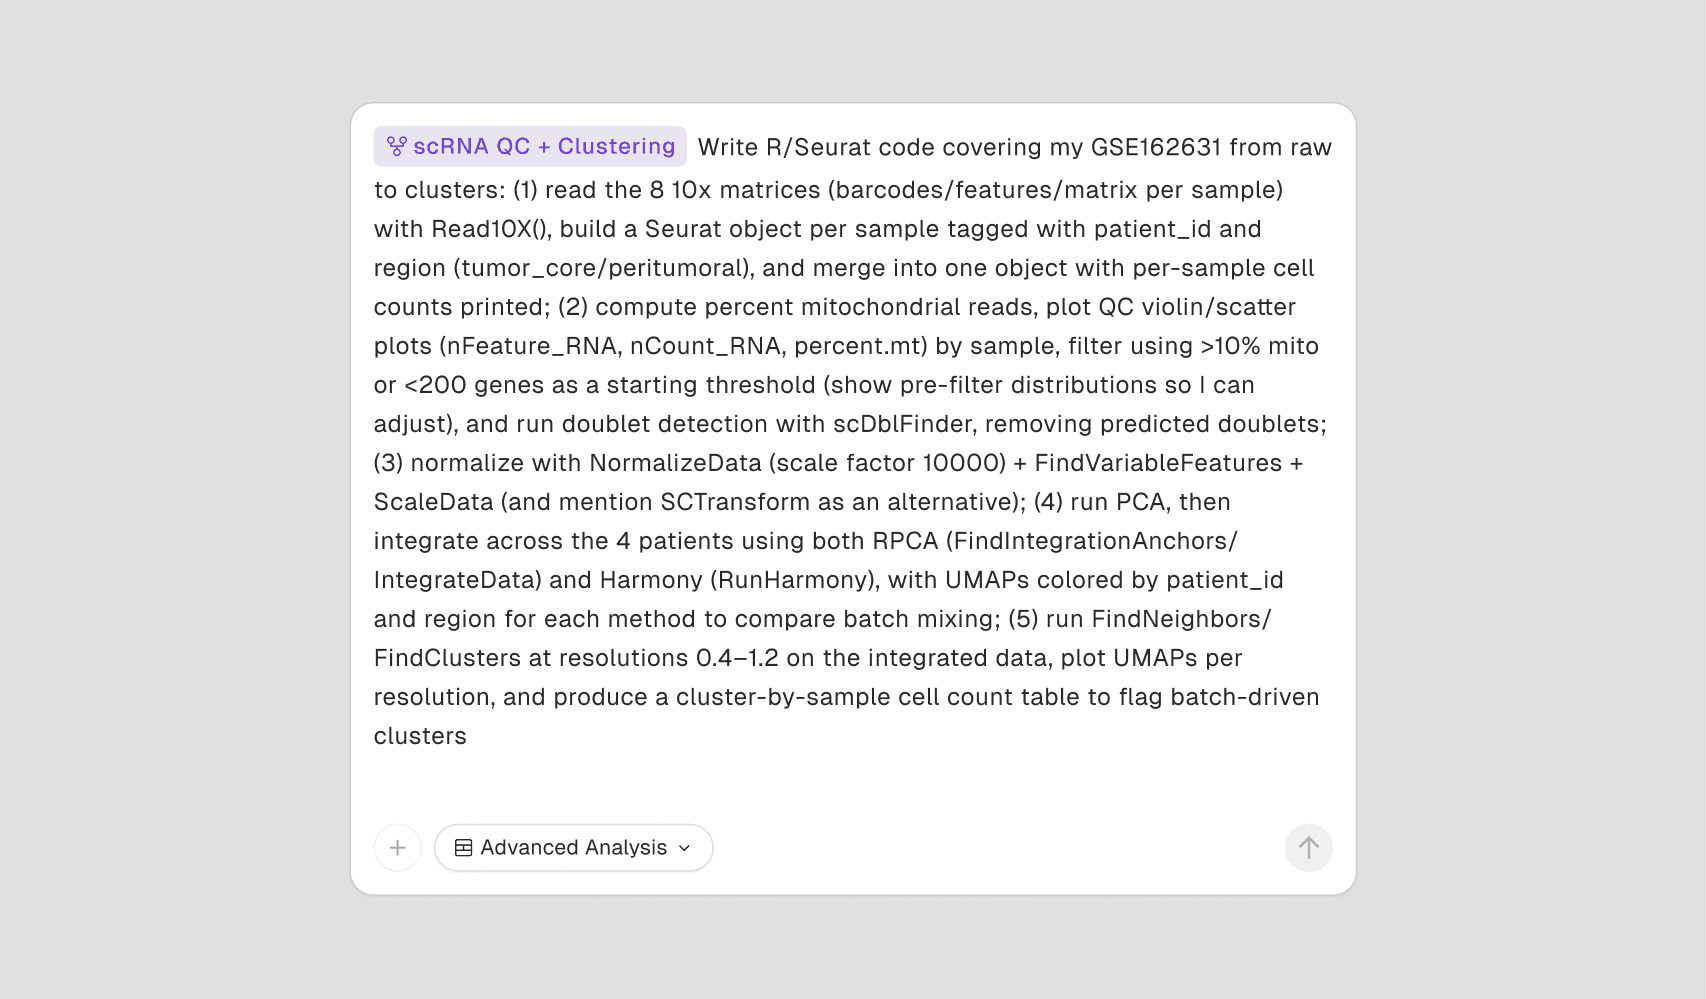
これは、このガイドの開始時に実際に使ったプロンプトです。@scRNA QC + Clustering に続けて、Drylab が必要とするすべての情報を書いています。
使うツール(Read10X、scDblFinder、NormalizeData、RPCA、Harmony)、閾値(ミトコンドリア >10%、遺伝子数 <200、解像度 0.4〜1.2)、メタデータのフィールド(patient_id、region)をすべて明記している点に注目してください。Drylab が推測しなければならない部分は何もありません。
2. 生成された計画を確認する
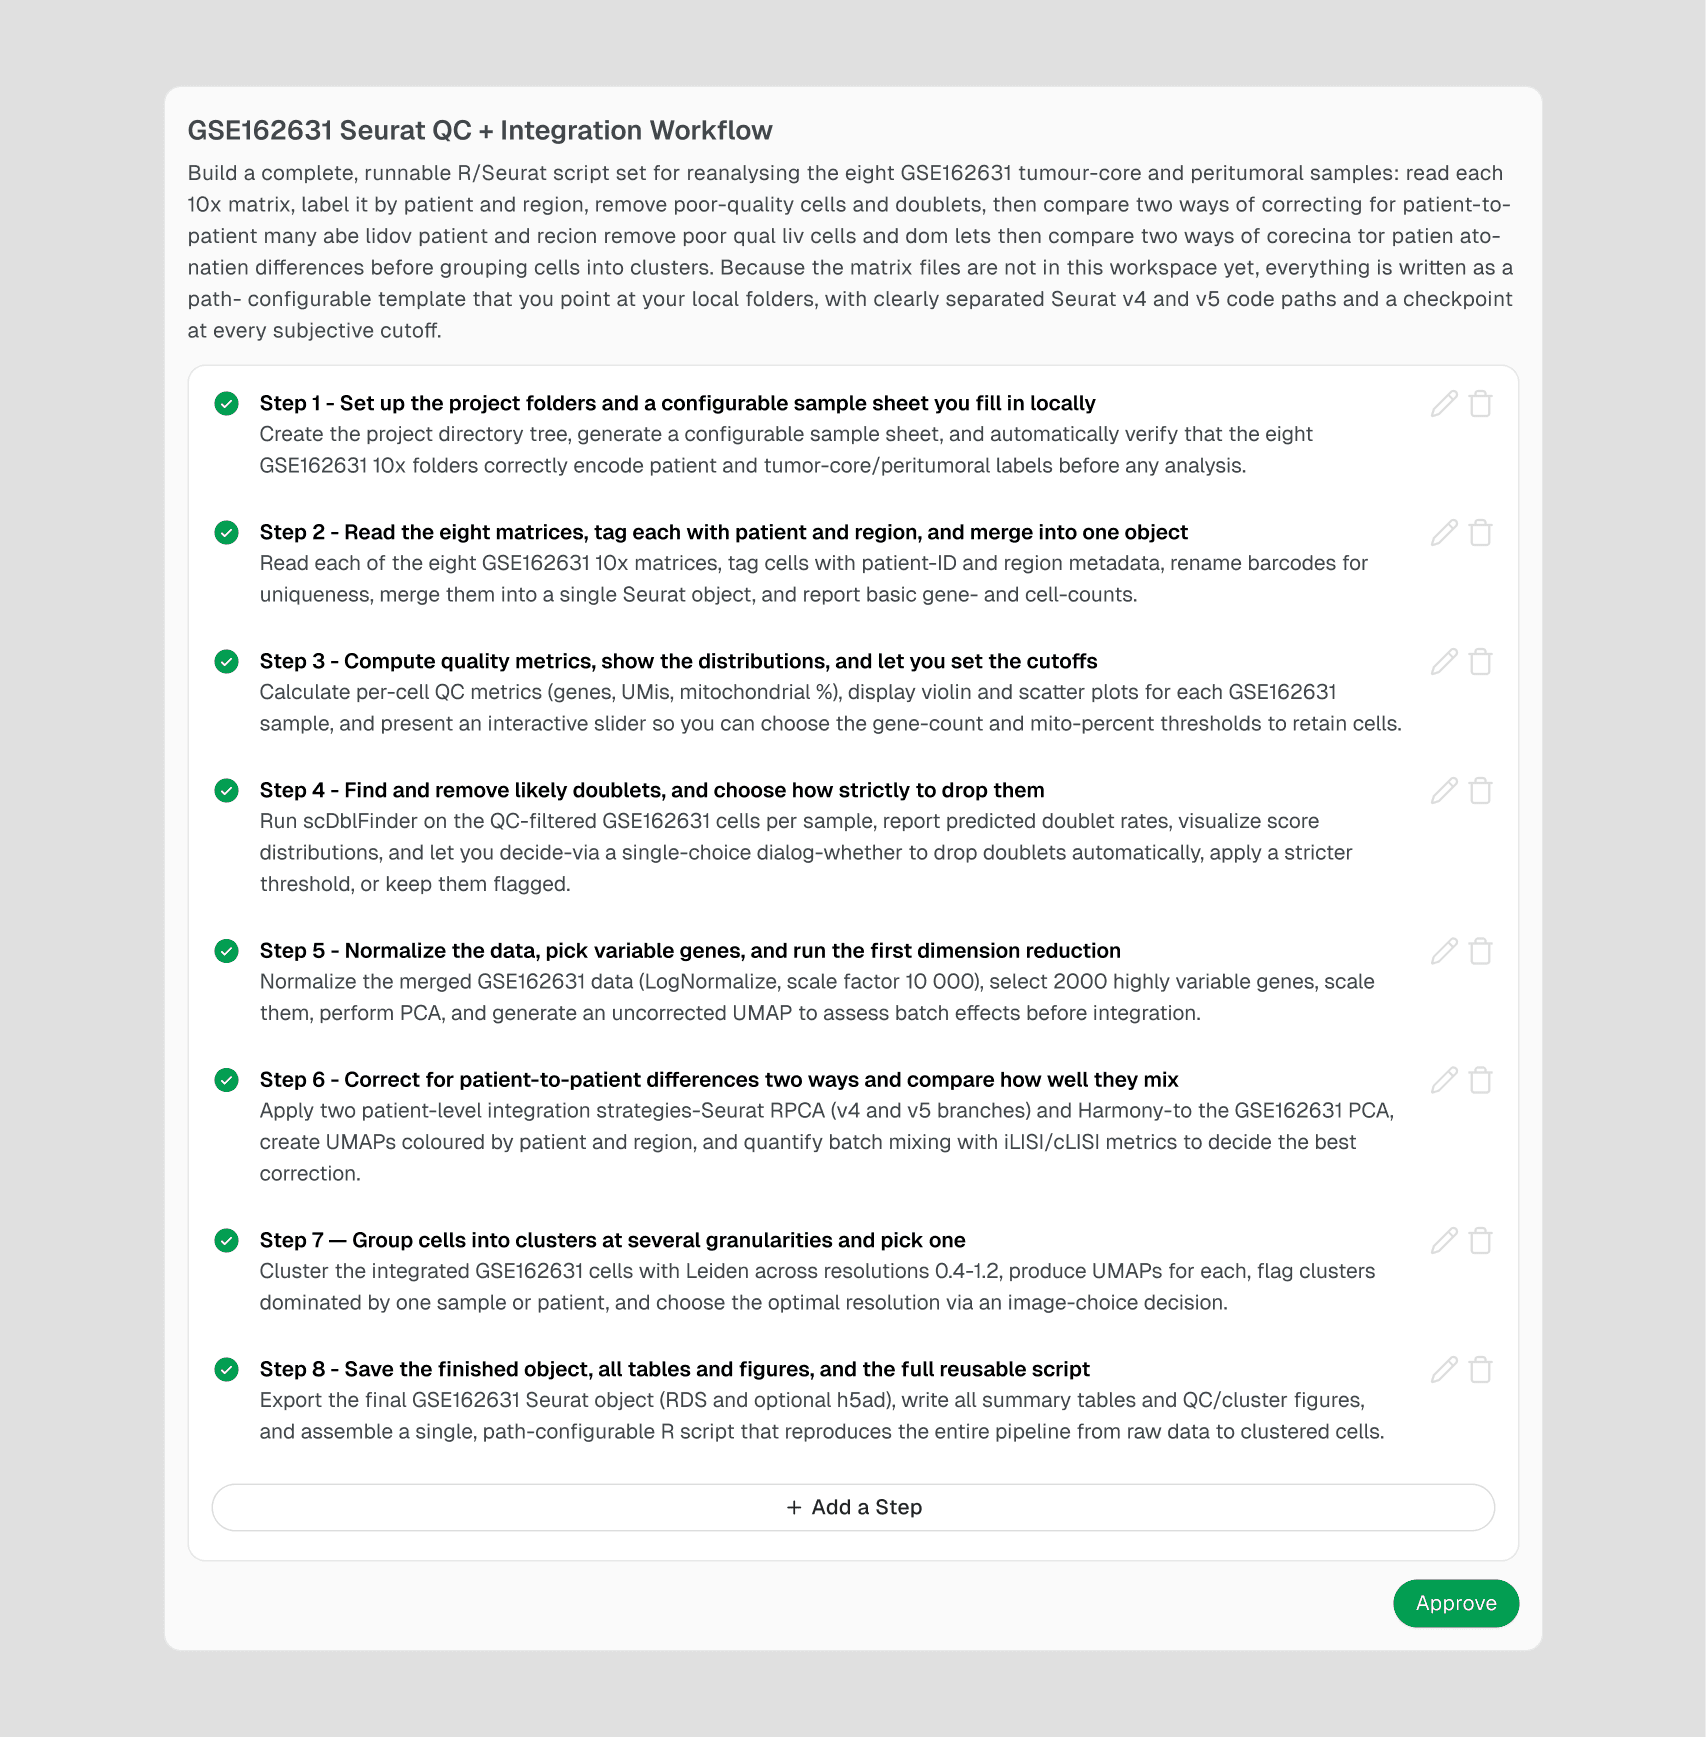
Drylab はプロンプトを、名前の付いた 8 つのステップに変換します。「プロジェクトのフォルダーと設定可能なサンプルシートを準備する」から「完成したオブジェクト、すべての表と図、再利用できる完全なスクリプトを保存する」までです。1 つずつ読み、気になる点があれば、計算が始まる前にここでステップを編集または削除しましょう。
3. 承認する、または推奨どおりに承認する
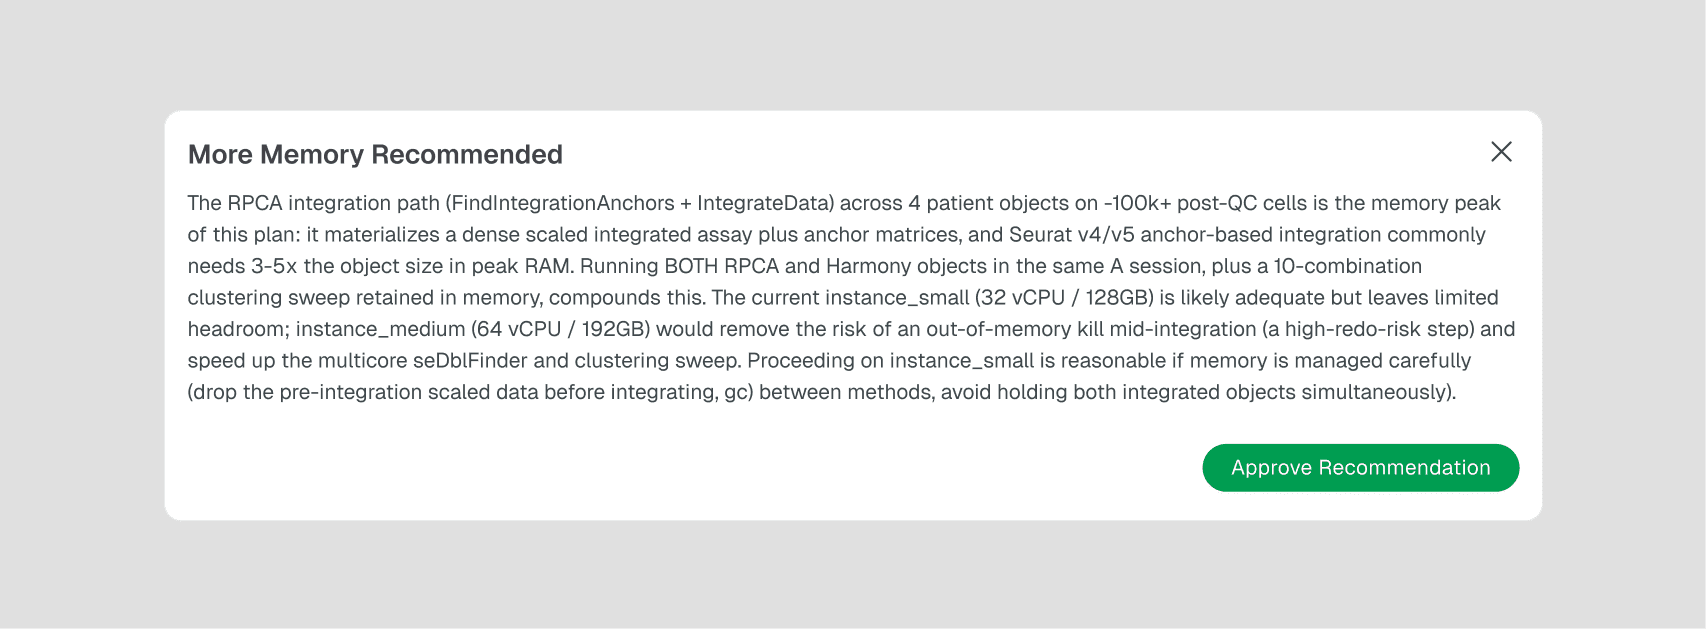
計画の一番下までスクロールすると、承認の前に Drylab がリソースに関する注意を示すことがあります。ここでは「より多くのメモリを推奨」と表示されています。1 つのセッションで RPCA と Harmony の両方の統合を実行すると、メモリを多く使うためです。プランを承認を押すと指定どおりに実行されます。<推奨インスタンス> で承認を押すと、推奨されたインスタンスサイズで実行されます。(スクリーンショットはこのカードの旧バージョンで、ボタンの表示は「Approve Recommendation」でした。)
4. 統合方法についての確認の質問に答える
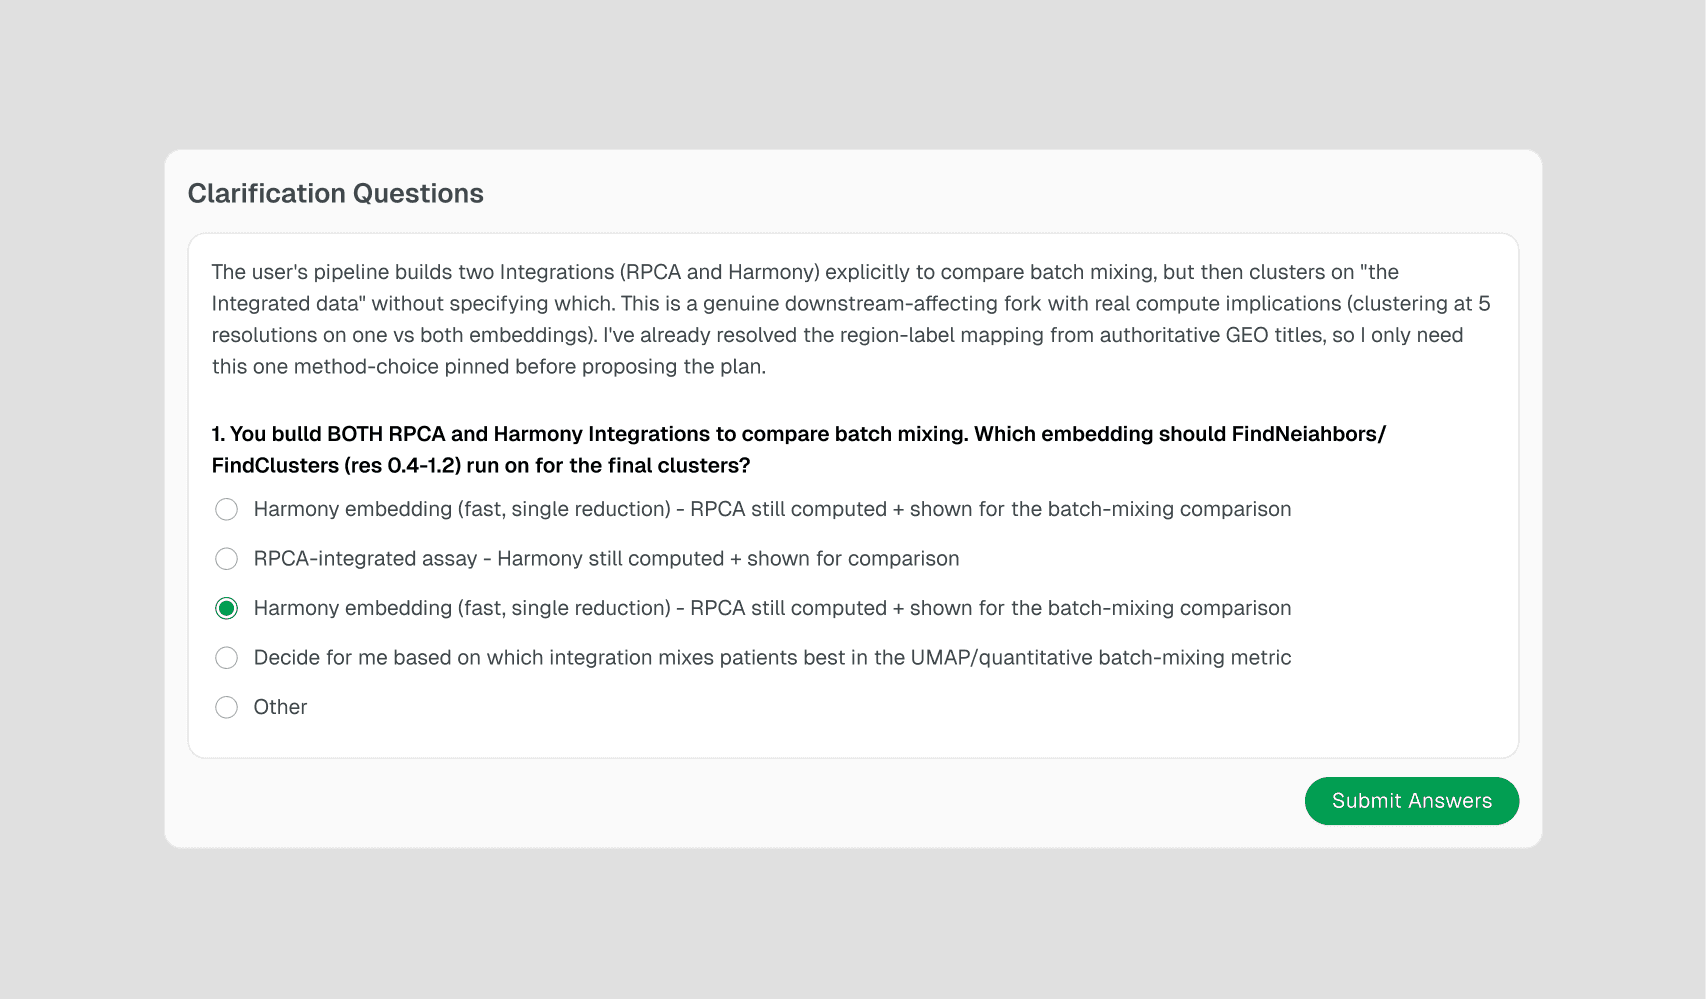
実行の途中で、Drylab は、ユーザーの判断が本当に必要な分岐点に差しかかります。プロンプトではバッチの混ざり具合を比べるために RPCA と Harmony の両方を求めていましたが、クラスタリングにどちらを使うかは指定していませんでした。Drylab はそれぞれの長所と短所を説明し、4 つの選択肢を示します。ここでは「両方でクラスタリングし、直接比較できるようにクラスター × サンプルの表を 2 つください」を選んでいます。Drylab のデフォルトの推奨をそのまま信じるのではなく、直接比較できるようにするためです。
5. リアルタイムの結果を見ながら QC の閾値をドラッグする
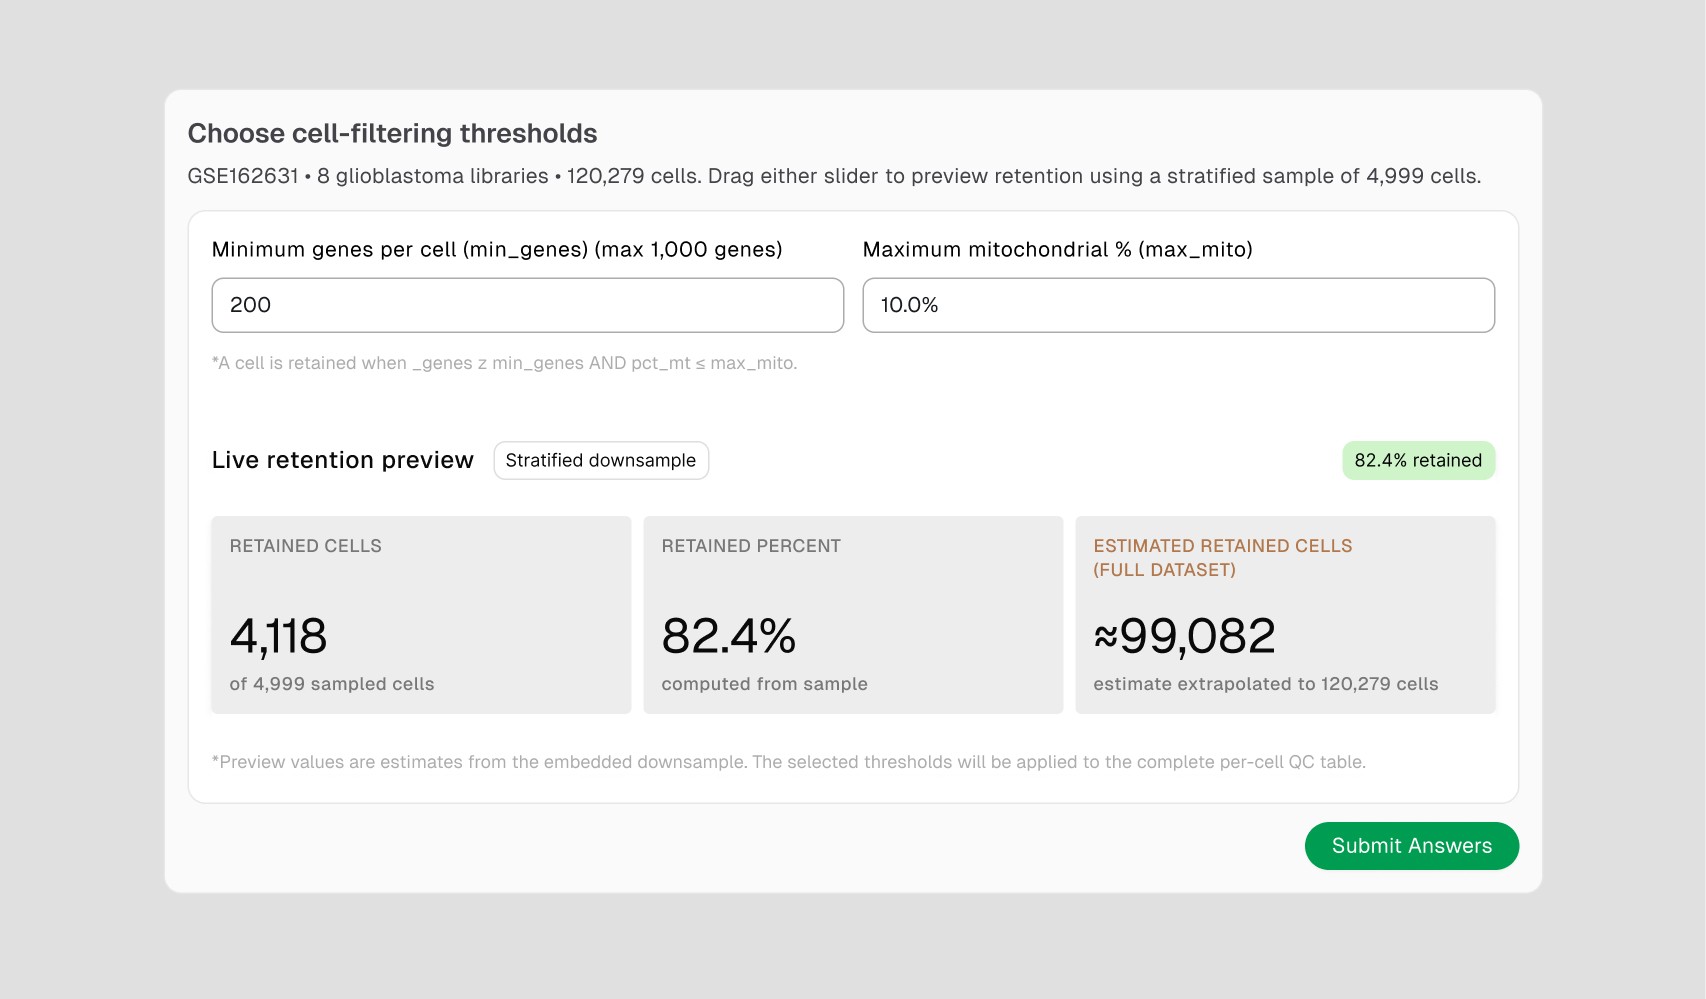
対話型の QC チェックポイントには、指定したデフォルト値(遺伝子数 200、ミトコンドリア 10%)があらかじめ入力されており、その影響がすぐに表示されます。このデフォルト値では、4,999 細胞の層別サンプルのうち 82.4% が保持され、全体に外挿すると 120,279 細胞中 約 99,082 細胞になります。確定する前にどちらかのスライダーをドラッグすれば、数値の変化を確認できます。結果を知るために再実行する必要はありません。
6. RPCA と Harmony を比べ、解像度を見た目で選ぶ
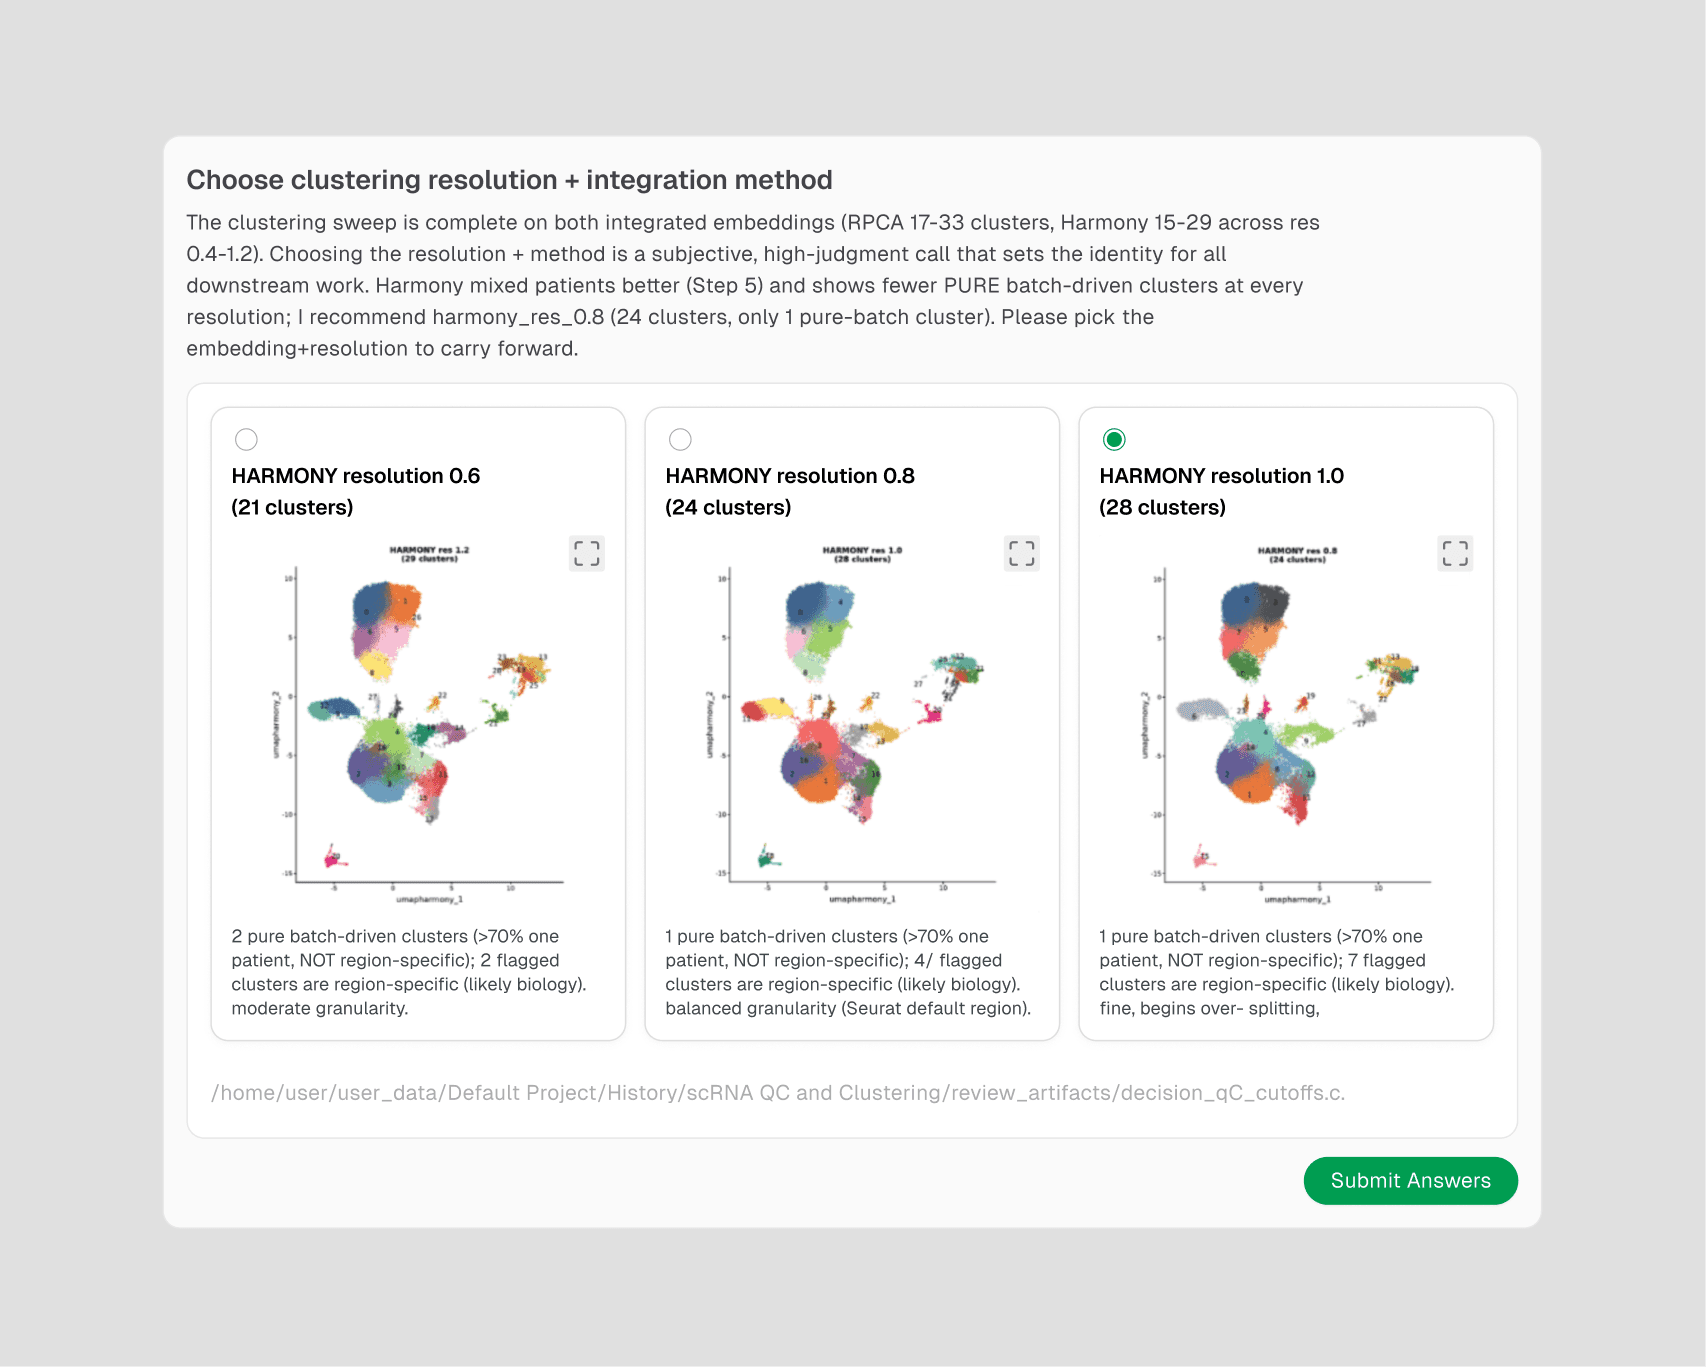
クラスタリングのスイープでは、両方の埋め込みについてそれぞれ 5 つの解像度で実行します(RPCA:17〜33 クラスター、Harmony:15〜29 クラスター)。Drylab は harmony_res_0.8 を推奨します。24 クラスターで、単一バッチだけからなるクラスターは 1 つのみと、どの選択肢よりも少ないためです。候補の UMAP はすべて並べて表示され、それぞれの下にバッチ由来のクラスター数が示されるので、推奨をうのみにせず自分で確かめられます。
7. 次に進む前に来歴の表を確認する
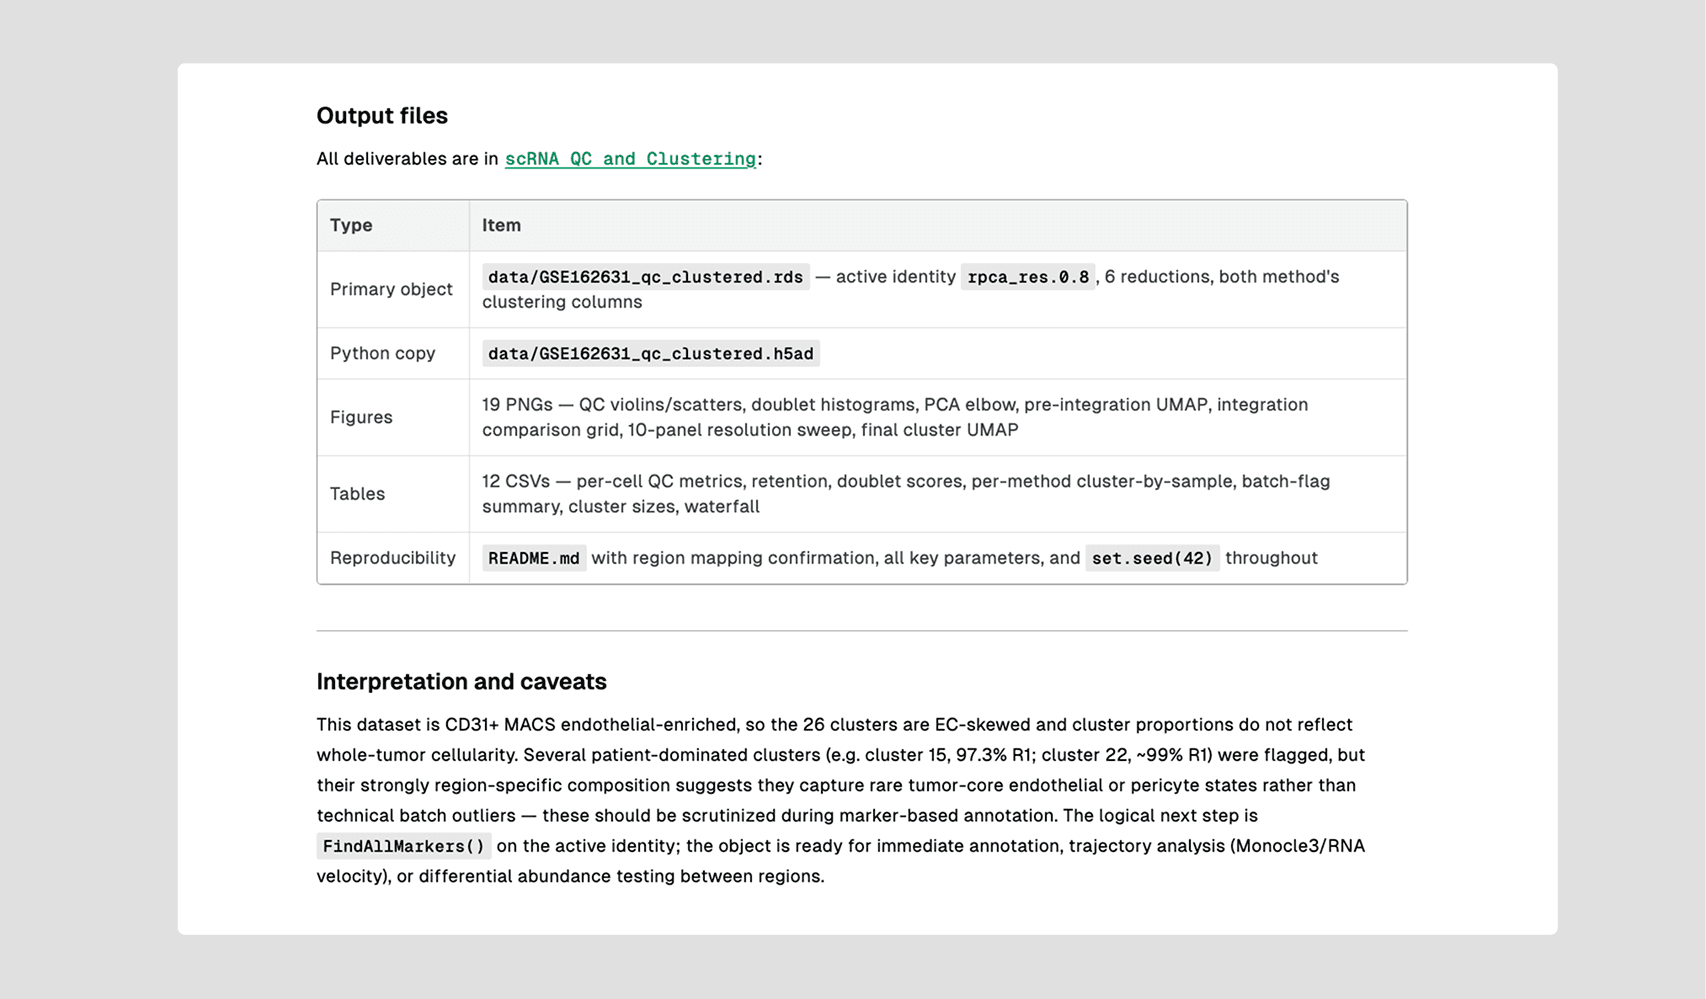
完了したステップは、何が作成されたかを正確に報告します:主となる .rds オブジェクト(アクティブな identity は rpca_res_0.8、両方の手法のクラスタリング列を保持)、Python で読める .h5ad のコピー、19 枚の図、12 個の表、そして領域の対応付けの確認、すべてのパラメーター、全体で set.seed(42) を使ったことを記録した README です。共同研究者に渡したり、半年後に見直したりするのは、まさにこの内容です。
ステージ 3:細胞タイプのアノテーション
作成したばかりのクラスタリング済みオブジェクトを使って、そのままラベル付けに進みます。
1. 独自のマーカーで Cell-Type Annotation につなげる
同じチャットで次のワークフローを指定し、汎用のデフォルトに頼らず定番のマーカーを渡します。実際に使ったプロンプトは次のとおりです。
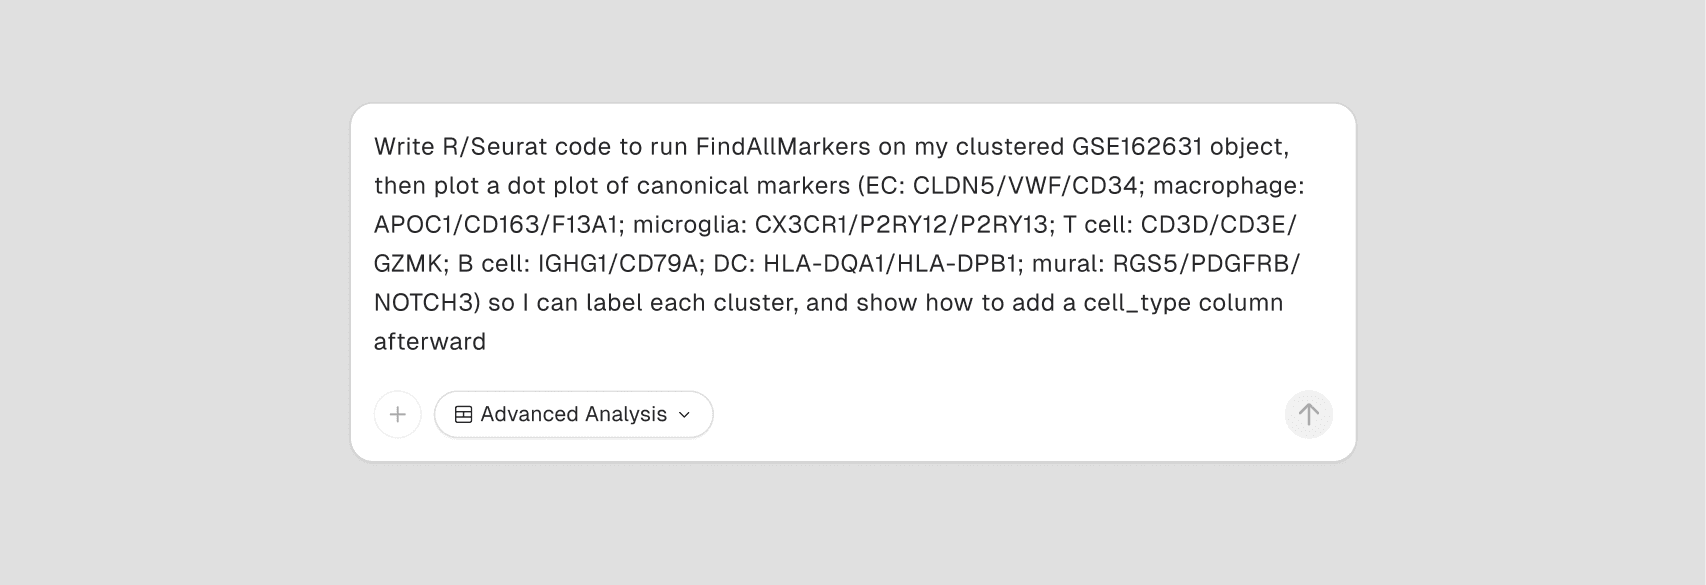
このマーカーパネルは、この腫瘍微小環境に合わせたものです(内皮細胞、マクロファージ、ミクログリア、T/B 細胞、DC、壁細胞)。ご自身の組織に合ったマーカーセットに差し替えてください。全体の流れ(FindAllMarkers → ドットプロット → ラベル付け → cell_type 列)は変わりません。
2. マーカーの根拠と照らして細胞タイプのラベルを確定する
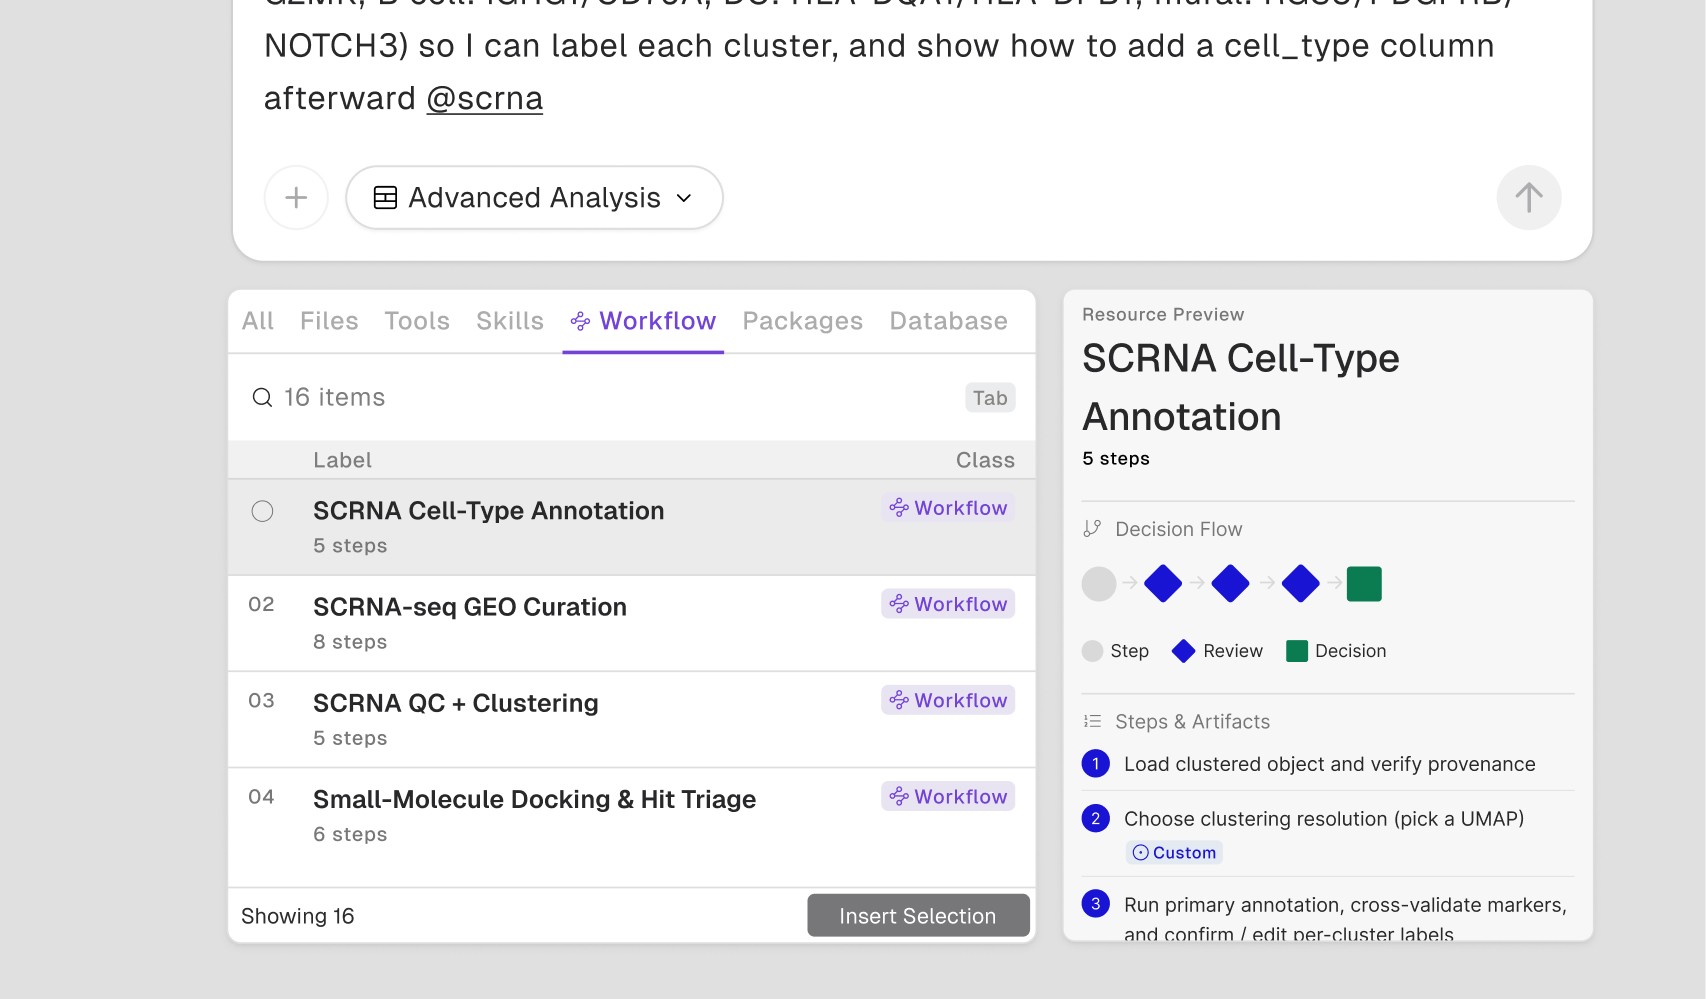
Cell-Type Annotation のドキュメントには、何が行われるかが書かれています:「候補の UMAP からクラスタリングの解像度を選び、マーカーの根拠と照らしてクラスターごとのラベルを確定し、どの混在クラスターをサブクラスタリングするか決め、あいまいな判定や信頼度の低い判定を解決し、来歴を記録したアノテーション済みオブジェクトをエクスポートします」ステップ 3 の Run primary annotation(一次アノテーションを実行)には Table Edit のタグが付いています。クラスターごとに生成されたラベルが表示され、マーカーパネルと合わないものは修正できます。
3. 混在した集団をサブクラスタリングするか決める
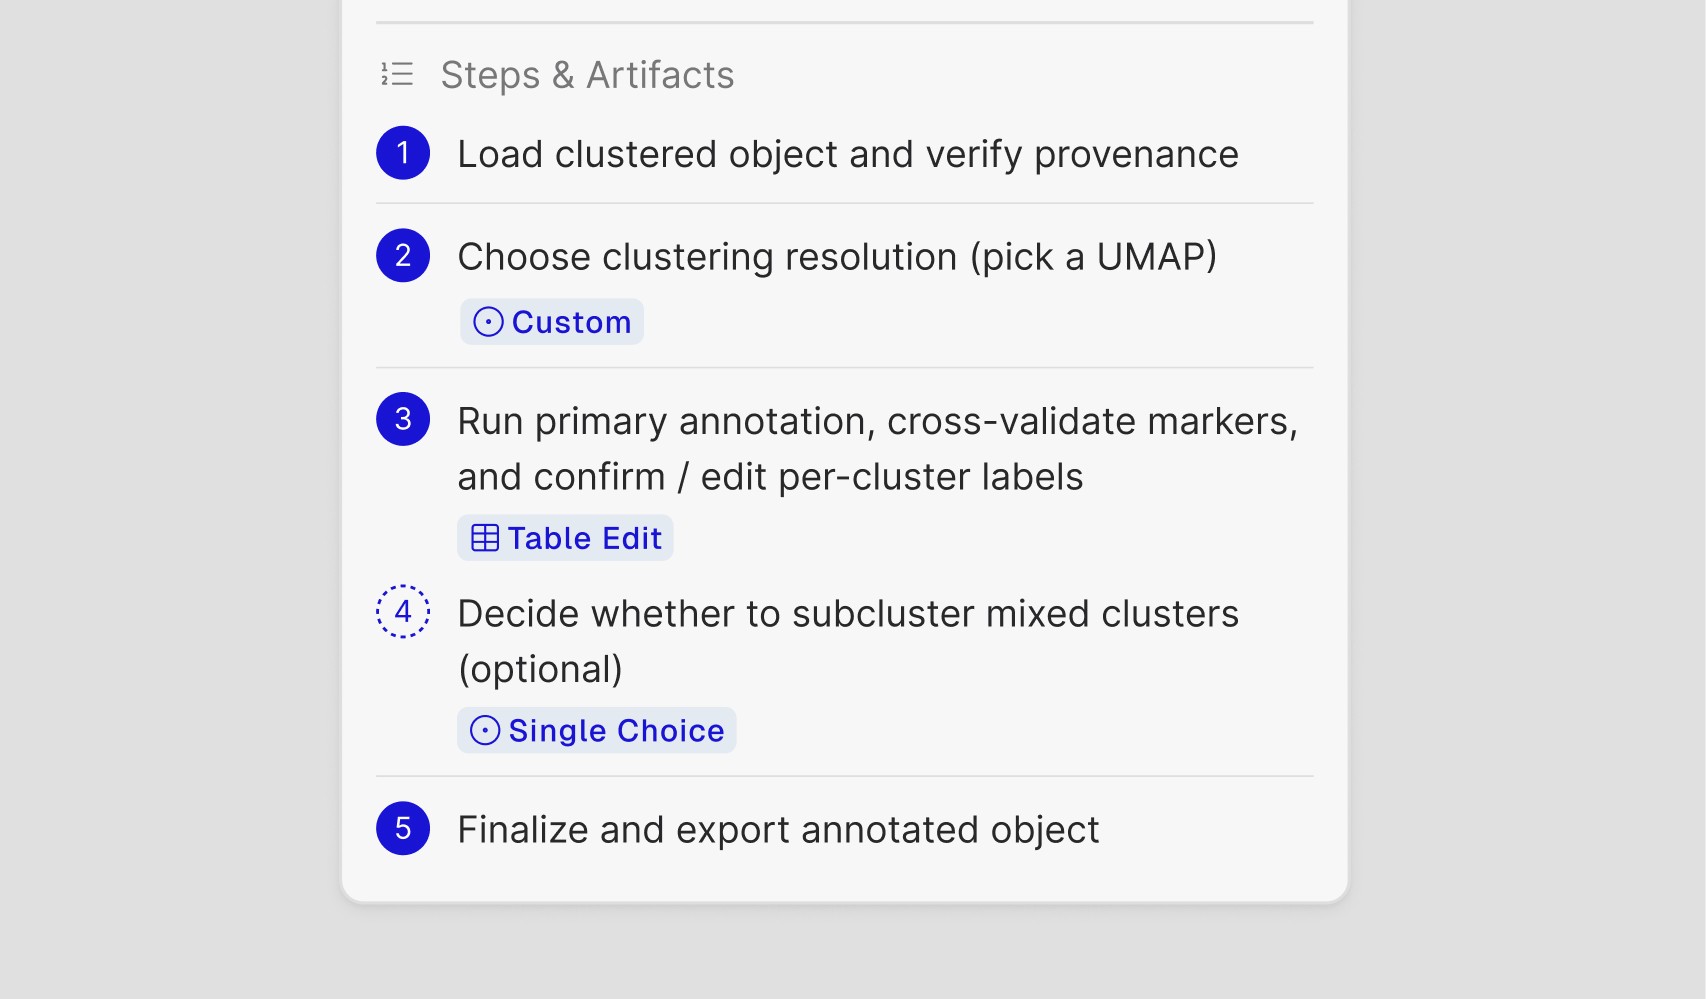
ステップ 4 は明示的に任意とされており、Single Choice のタグが付いています。あるクラスターでマーカーのシグナルが混在している場合(たとえばマクロファージとミクログリアの両方のマーカーが見られる場合)、さらに分割するか、1 つの集団として扱うかを自分で決めます。勝手にサブクラスタリングされることはありません。選択肢が表示され、判断を待ちます。