
技巧与最佳实践
Drylab 团队的建议
Drylab 团队分享的实用建议:如何向 AI 交代任务,更快拿到准确的结果。
生物信息分析很容易变得复杂,不同的数据集在工作流的每个阶段都需要不同的工具。
无论你是从原始数据开始,还是已经有处理好的对象,选对分析路径都至关重要。
以下是 Drylab 团队的几条建议:
1. 说明科学目标
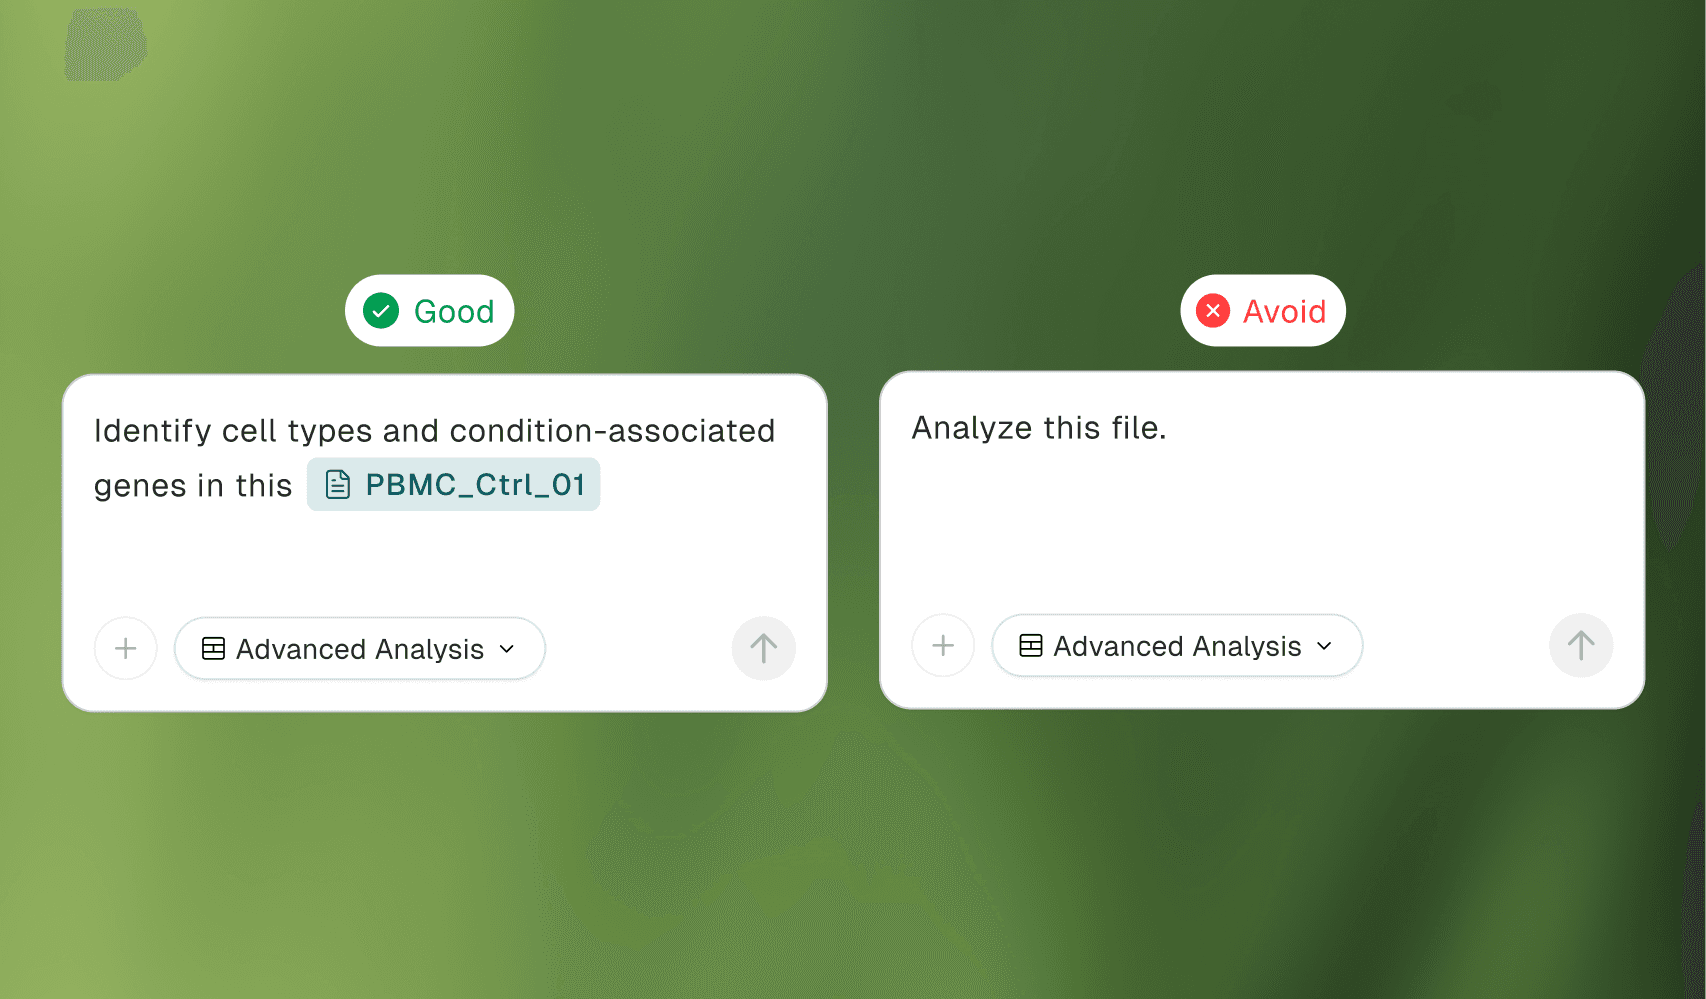
2. 提供输入数据和实验设计
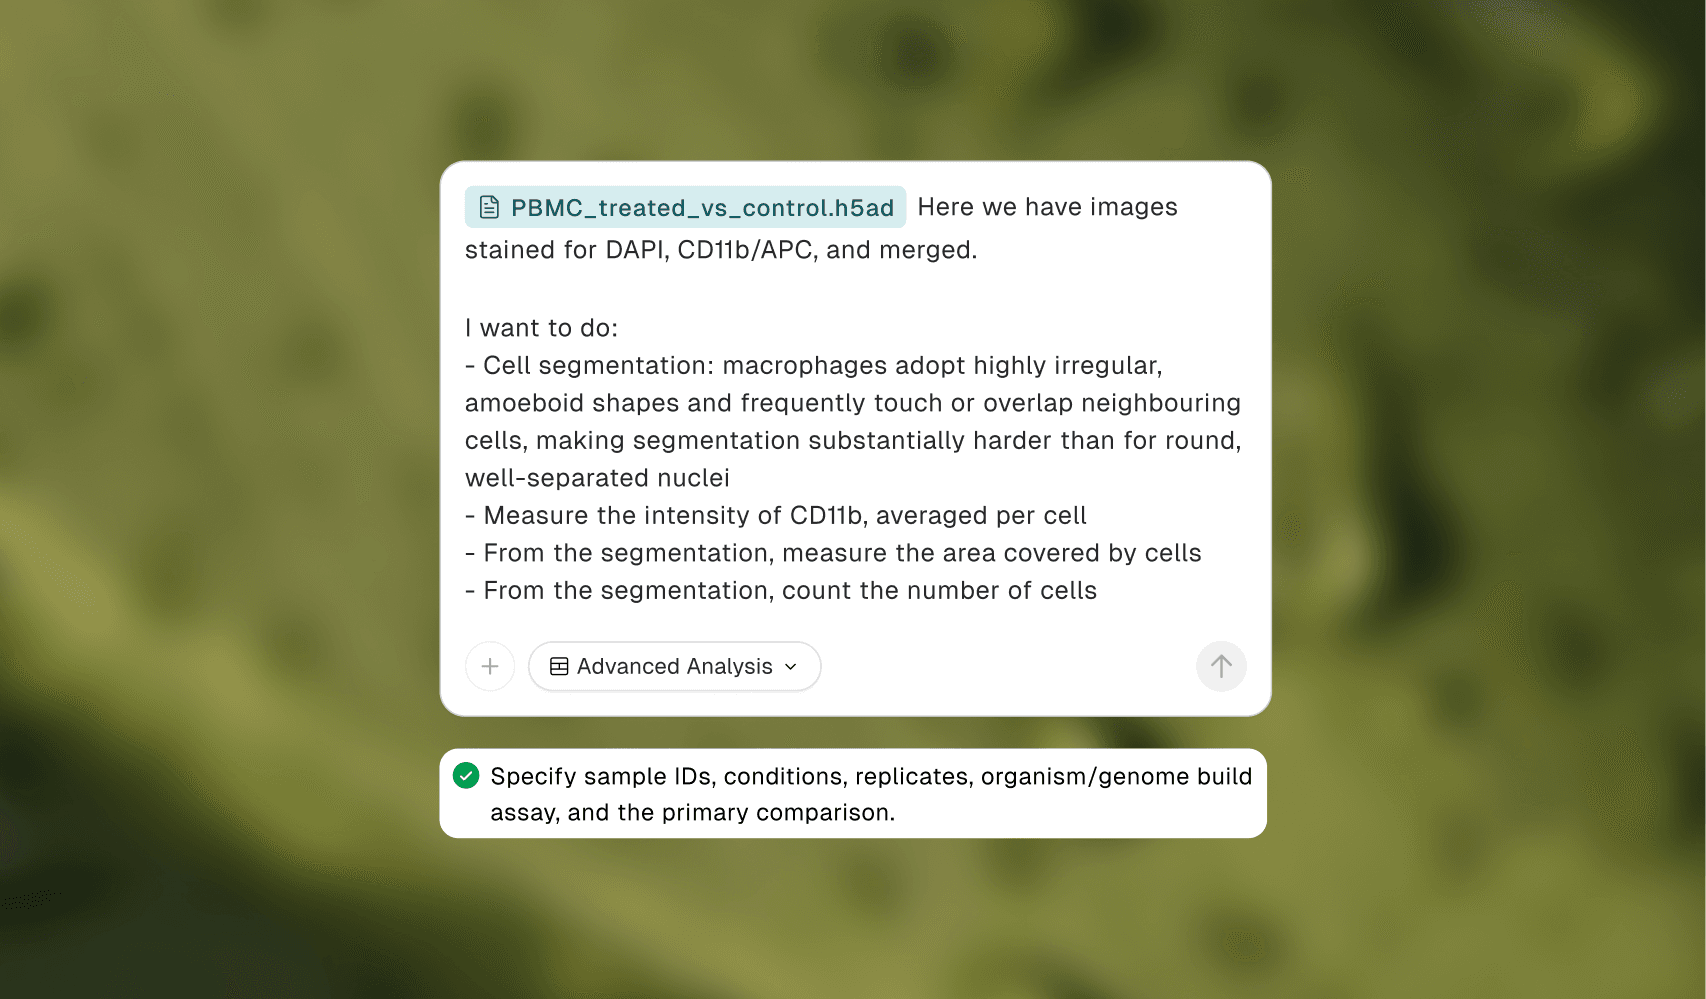
- 上传数据(点击聊天框中的 +、把文件拖进来,或粘贴图片),或者用
@指向存储中已有的文件。 - 写明样本 ID、实验条件、重复数、物种/基因组版本、检测方法,以及主要的比较组。
3. 用“@”调用工具
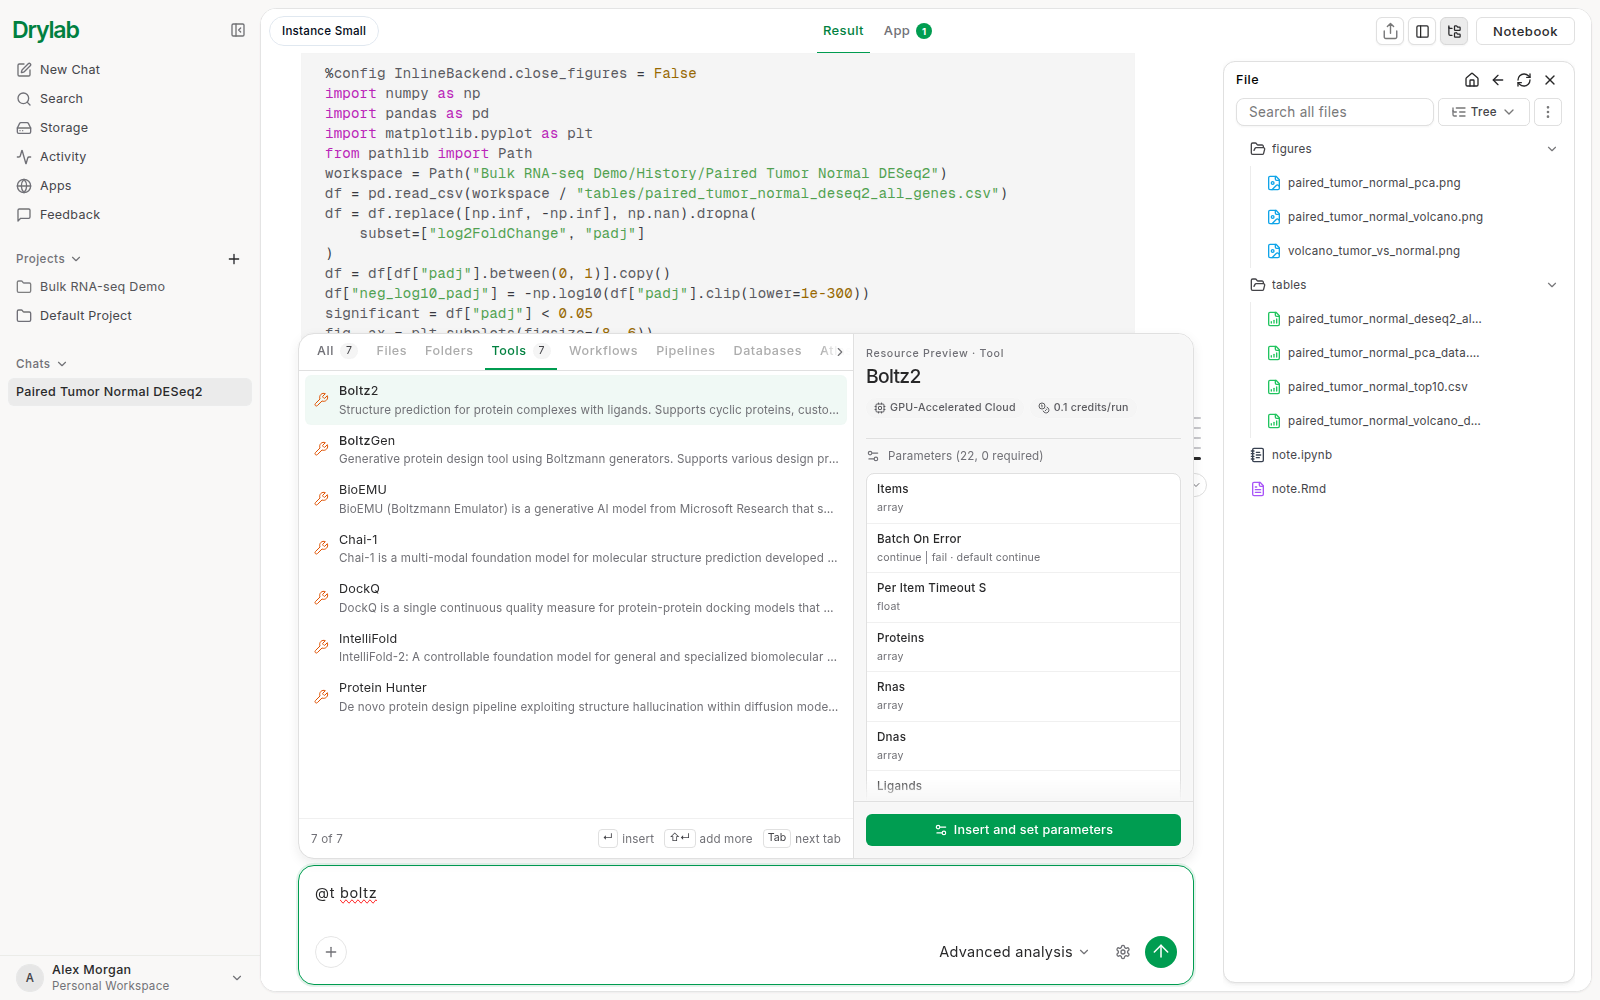
在聊天框中输入 @,打开选择器,里面有全部、文件、文件夹、工具、工作流、流程、数据库、Atlas 和你的数据等标签页。继续输入可以筛选(例如用 @t autodock 找工具);把鼠标悬停在某一项上,可以看到它的资源预览(工具还会显示每次运行的费用)。详见提及文件和资源。
这能让 Drylab 一开始就抓住正确的上下文,更快给出更准确的结果。
4. 先让 Drylab 检查一遍
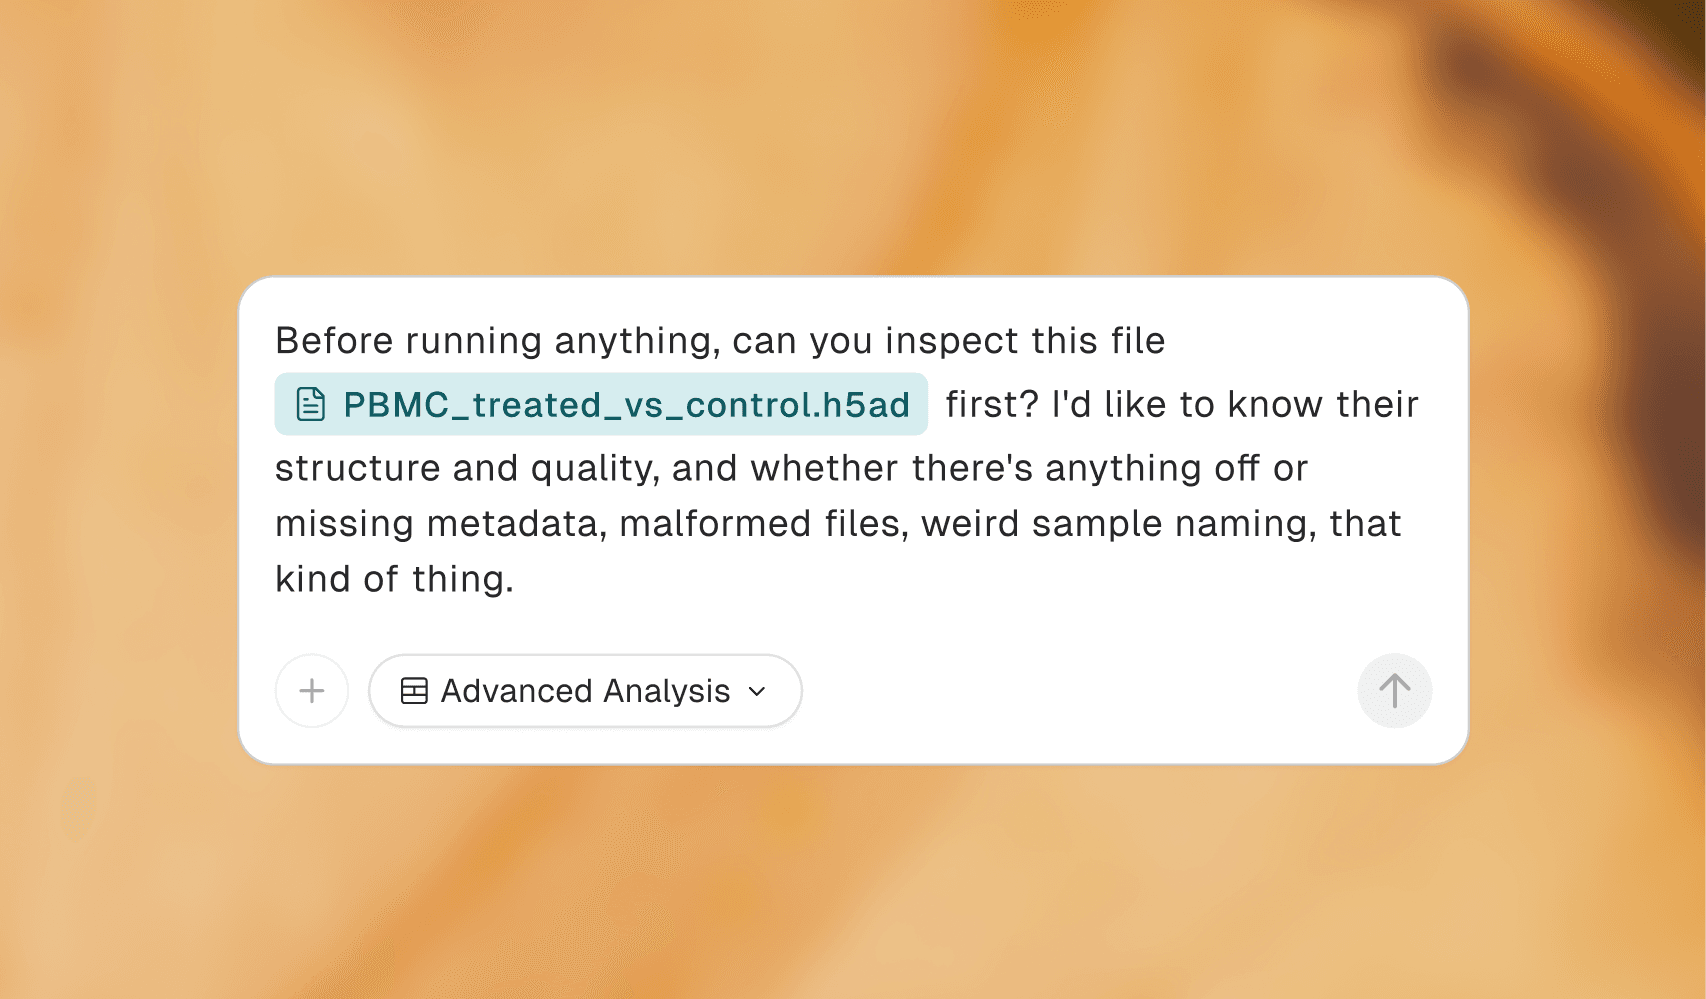
- 示例:“检查这些文件,报告它们的结构和质量,并提出一个分析计划。”
- 这样可以在耗费大量计算之前,发现缺失的元数据、格式错误的文件和设计上的问题。
5. 把需要判断的参数说清楚
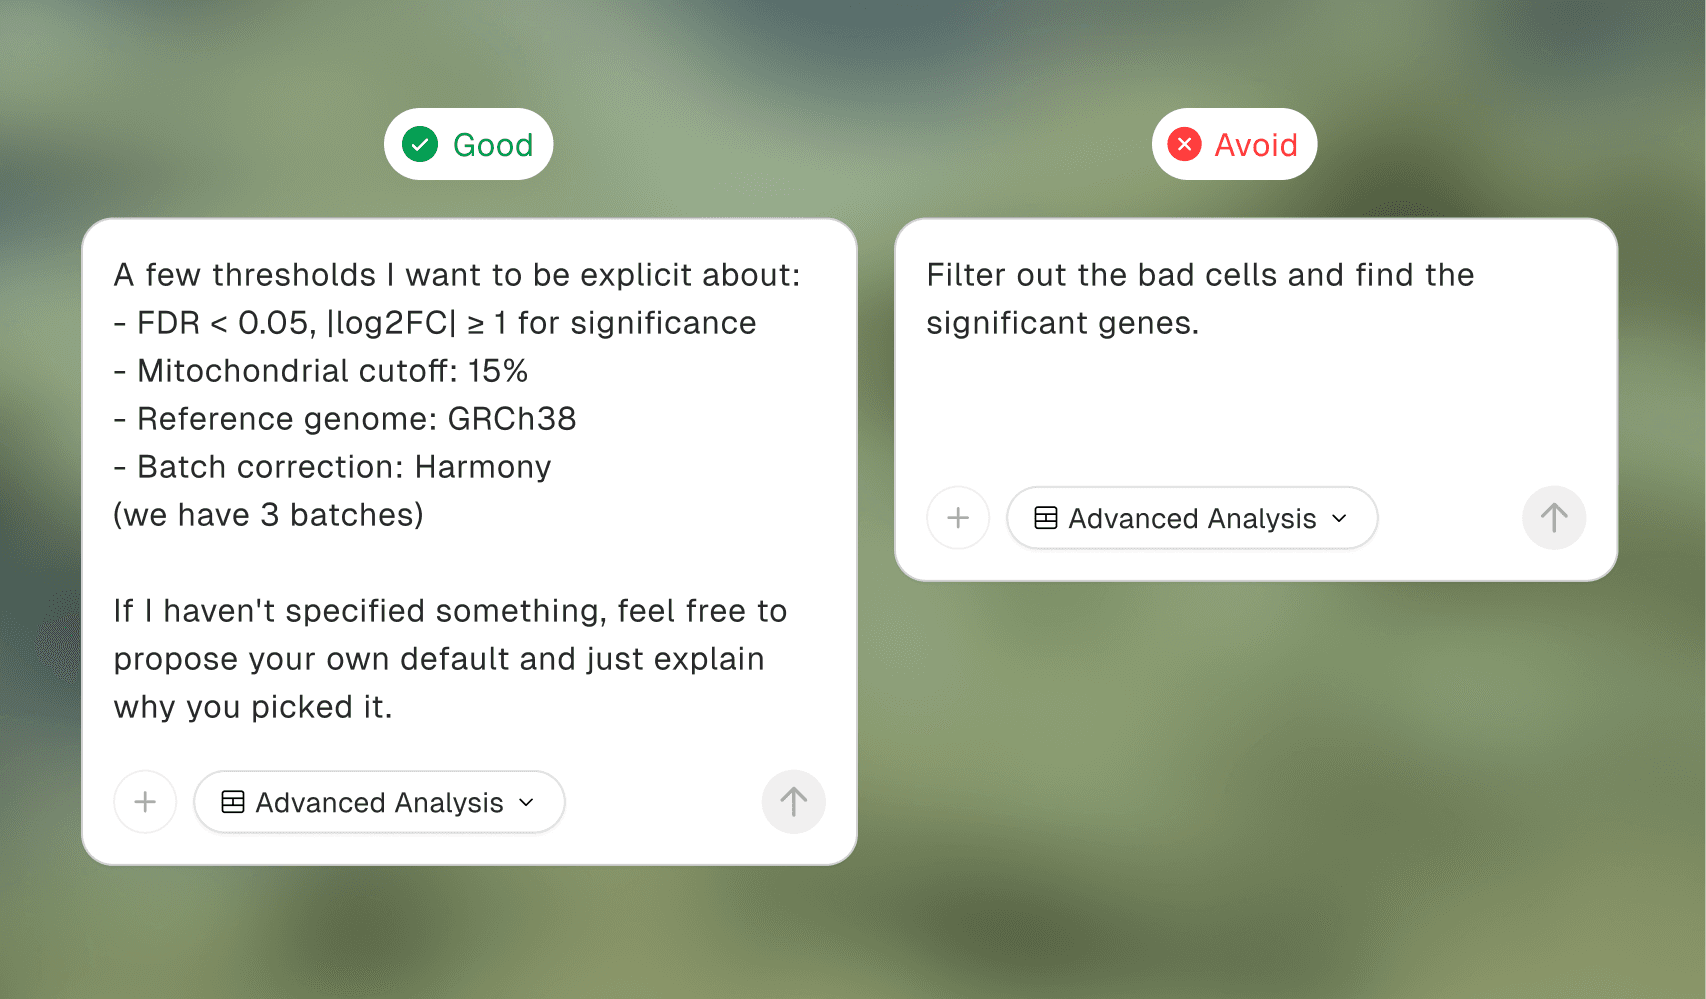
- 阈值重要时要写明:例如 FDR < 0.05、|log2FC| ≥ 1、线粒体比例阈值、参考基因组或批次校正策略。
- 如果你没有偏好,可以让 Drylab 提出默认值并解释理由。
6. 多阶段任务先批准计划
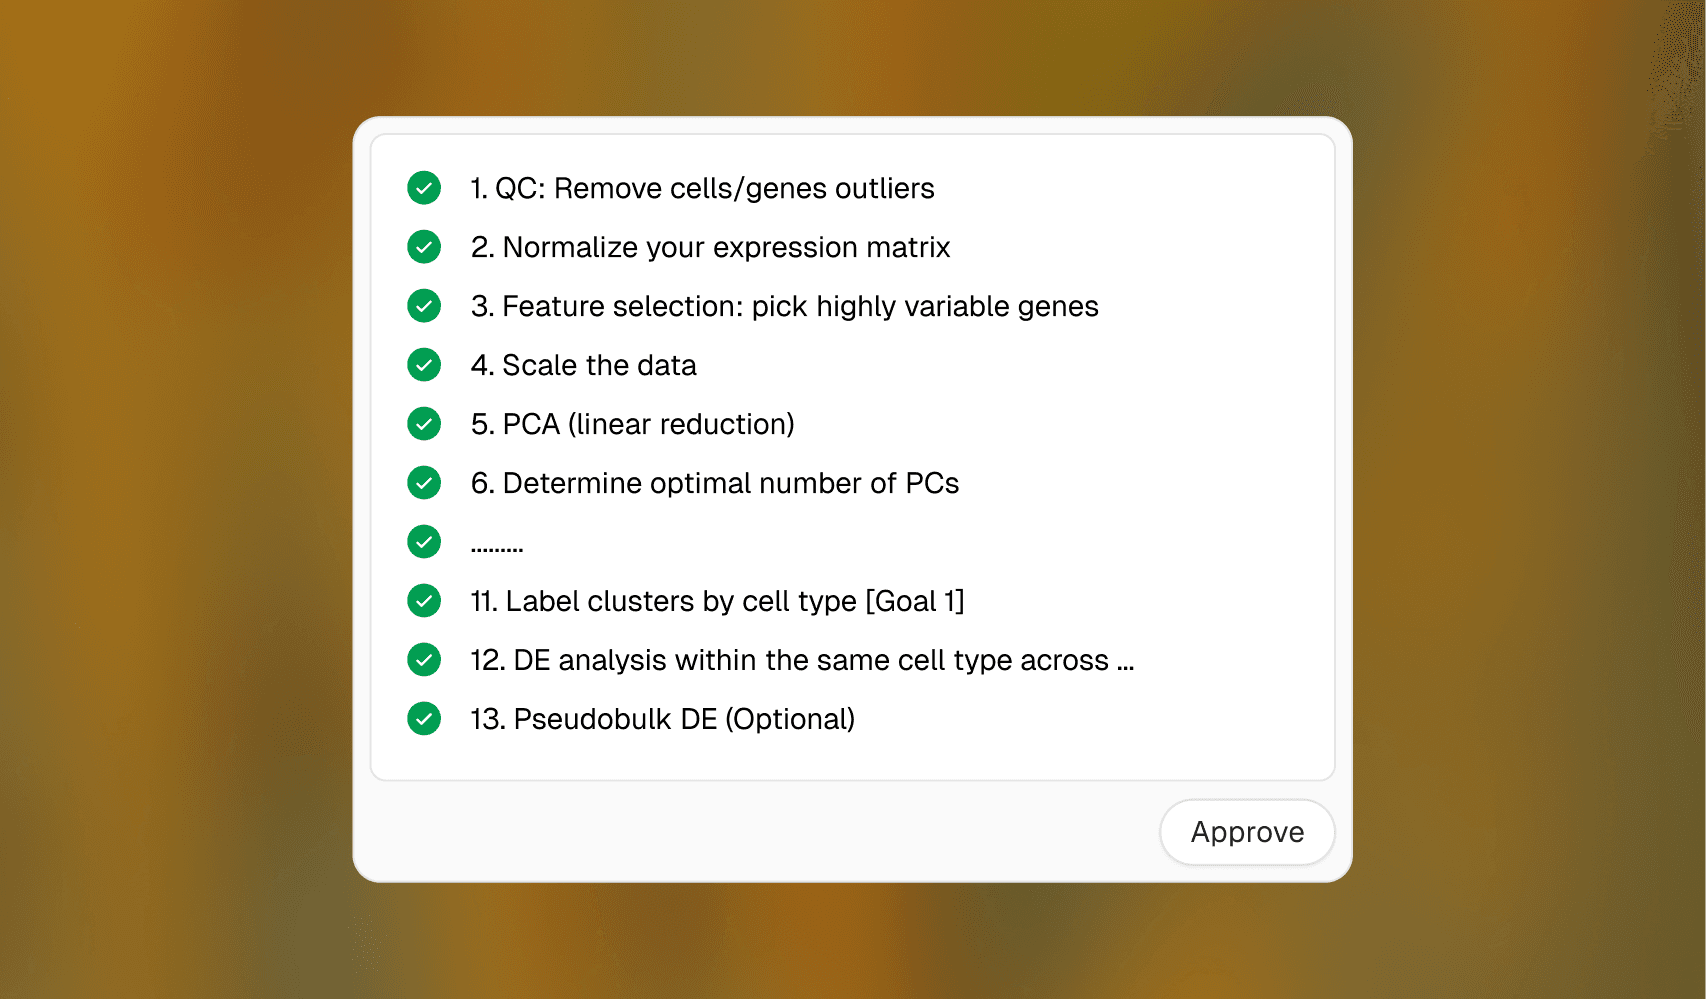
典型的顺序:
- 数据验证/QC
- 预处理与标准化
- 核心分析(例如聚类、差异表达、变异检测)
- 结果解读/富集分析
- 图、表格,以及保存可复现的输出