
技巧与最佳实践
Drylab 中的 scRNA-seq 工作流
完整演示 GSE162631(胶质母细胞瘤 scRNA-seq)的分析:从原始 10x 计数到注释好的聚类,附上每一步实际使用的提示词。
完整演示 GSE162631(胶质母细胞瘤 scRNA-seq)的分析:从原始 10x 计数到注释好的聚类,附上每一步实际使用的提示词。
阶段 1:准备
在开始运行之前,先找到合适的工作流,并把任务交代清楚。
1. 找到工作流:搜索 @scrna
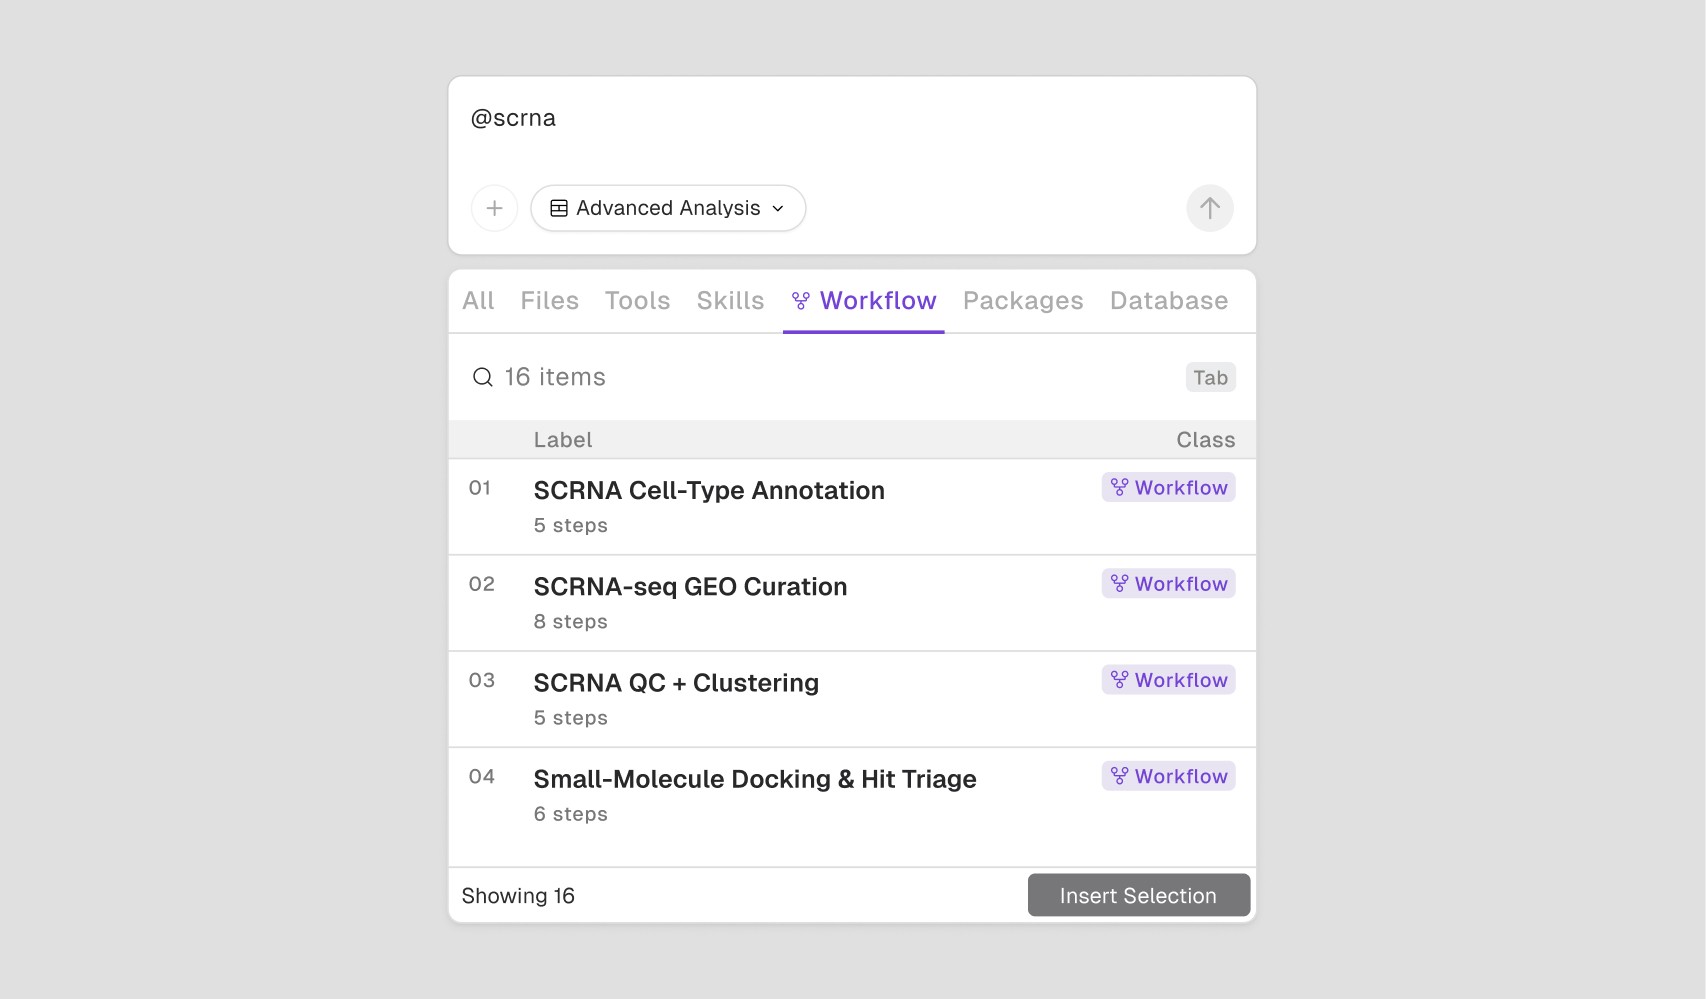
在新对话中输入 @scrna。Drylab 会筛选出单细胞相关的工作流:scRNA Cell-Type Annotation、scRNA QC + Clustering 和 Spatial Domain Detection & Annotation。本演示先用 scRNA QC + Clustering,之后再接着运行 scRNA Cell-Type Annotation。
2. 预览:看清编号步骤和它们的标签
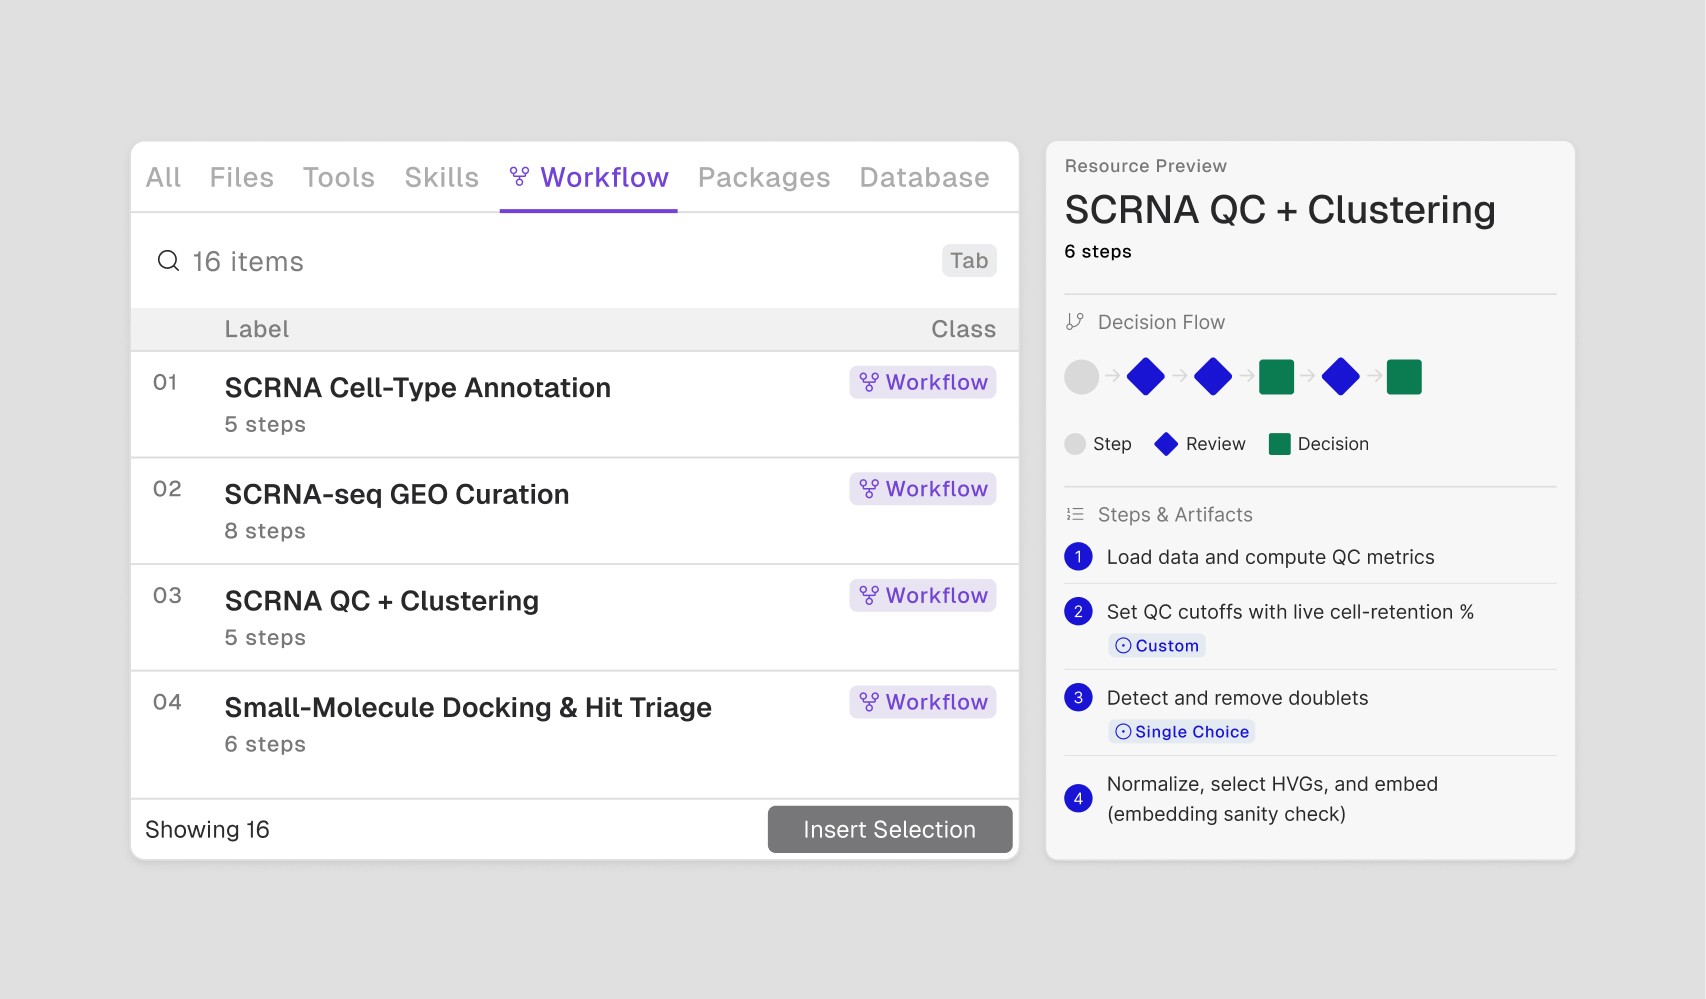
选中之前,先滚动查看资源预览。scRNA QC + Clustering 共六步:(1)Load data and compute QC metrics(加载数据并计算 QC 指标),(2)Set QC cutoffs(设置 QC 阈值):自定义,(3)Detect and remove doublets(检测并去除双细胞):单选,(4)Normalize, select HVGs, and embed(标准化、选择高变基因并降维嵌入):设门树,(5)Choose clustering resolution(选择聚类分辨率):图片选择,(6)Export QC'd + clustered object(导出完成 QC 和聚类的对象)。六步中有四步会暂停等你输入,标签会告诉你是哪几步、以什么方式。
3. 阅读文档和使用的技能
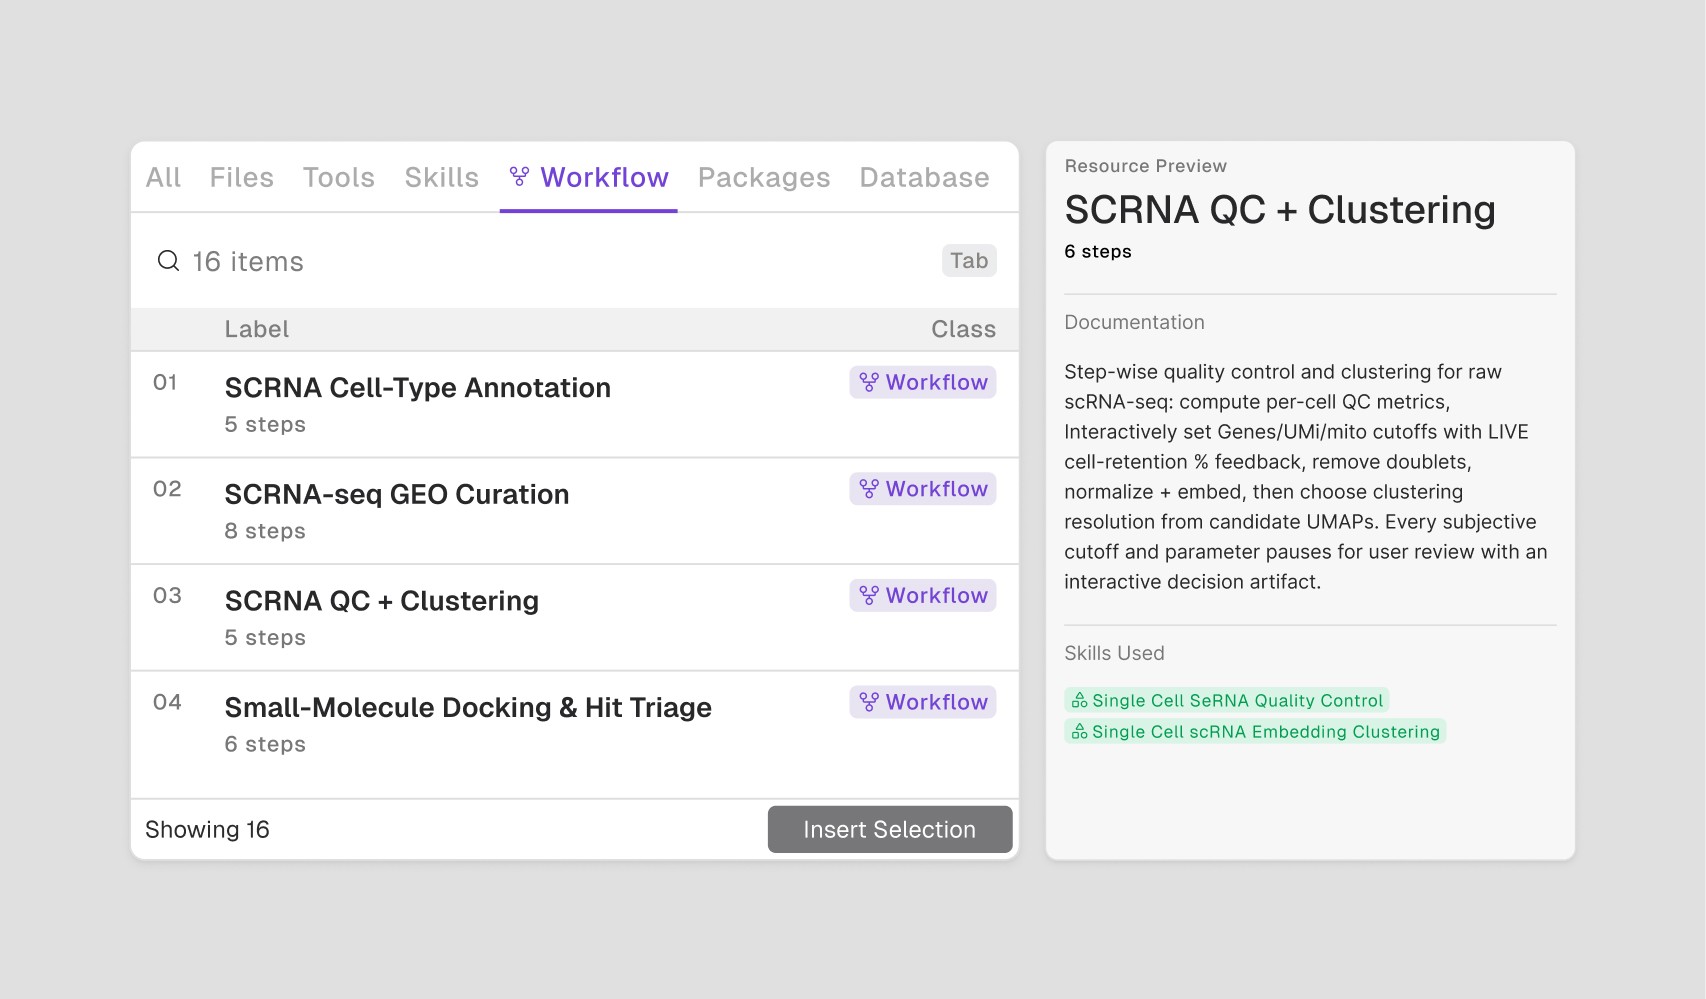
文档说明了这正是你要的工作流:“对原始 scRNA-seq 数据逐步进行质控和聚类:计算每个细胞的 QC 指标,交互式设置 nGenes/UMI/线粒体阈值并实时查看细胞保留比例,去除双细胞,标准化并降维嵌入,然后从候选 UMAP 中选择聚类分辨率。”“使用的技能”中列出了 Single Cell scRNA Quality Control 和 Single Cell scRNA Embedding Clustering。
4. 设置审查模式
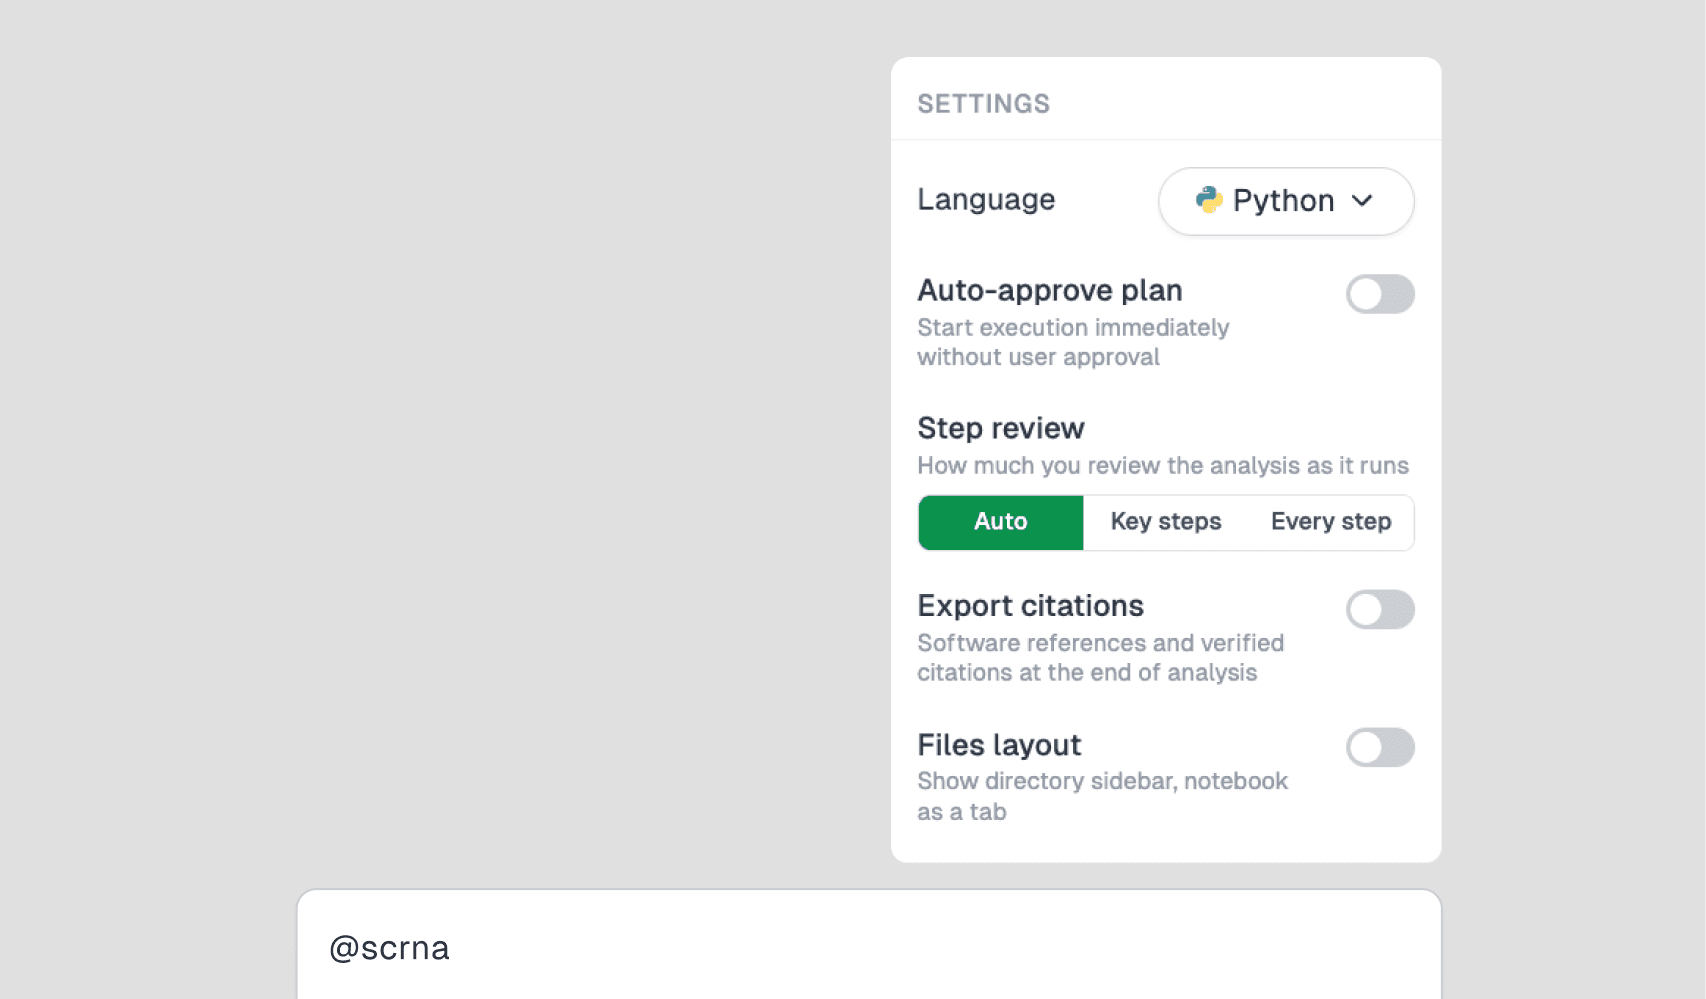
打开运行设置(聊天框中模式按钮旁边的齿轮)。逐步审查有三个选项:自动(你批准计划后运行整个计划)、关键步骤(只在主观、高风险的步骤暂停,例如细胞类型注释)和每一步。如果你是第一次在这个数据集上运行 QC + Clustering,请选择每一步,这样每个检查点出现时你都能看到。确认阈值没问题后,重新运行时可以放宽到关键步骤或自动。详见运行设置。
阶段 2:QC 与聚类
启动分析,然后在 Drylab 给出每个检查点时逐一处理。
1. 用写全细节的提示词启动
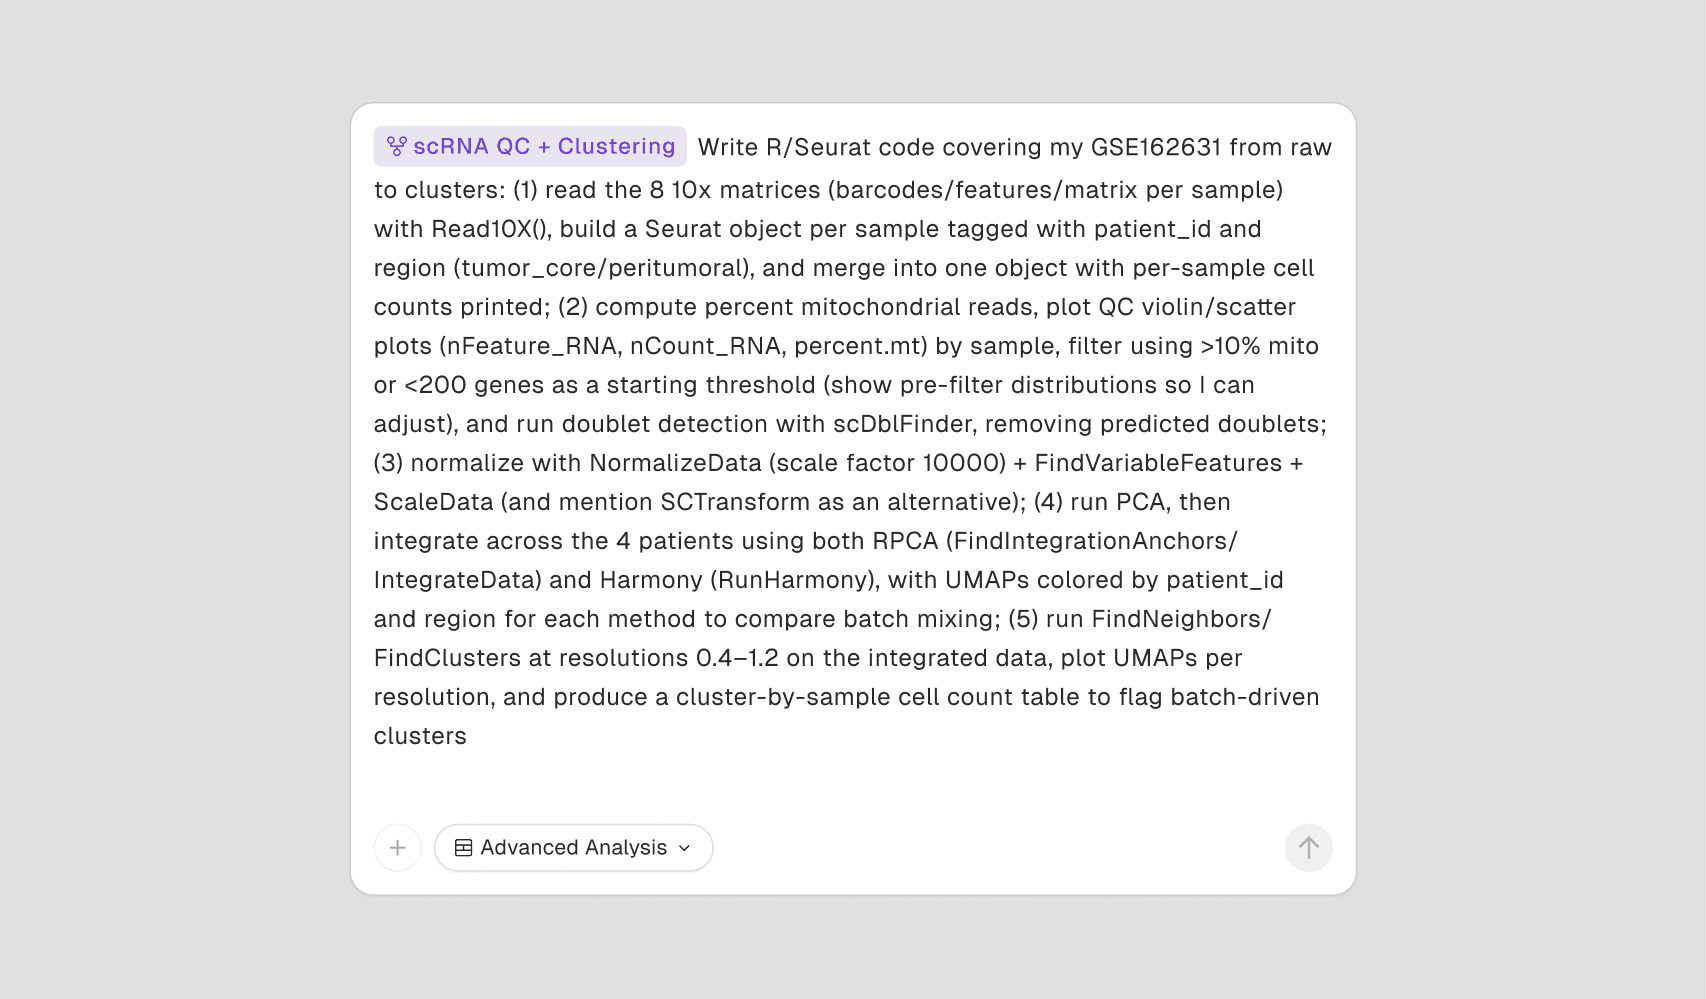
这是本演示开始时实际使用的提示词:先写 @scRNA QC + Clustering,后面跟上 Drylab 需要的所有细节:
注意,它写明了每个工具(Read10X、scDblFinder、NormalizeData、RPCA、Harmony)、每个阈值(线粒体 >10%、基因数 <200、分辨率 0.4–1.2)和每个元数据字段(patient_id、region),没有留下任何需要 Drylab 去猜的东西。
2. 审查生成的计划
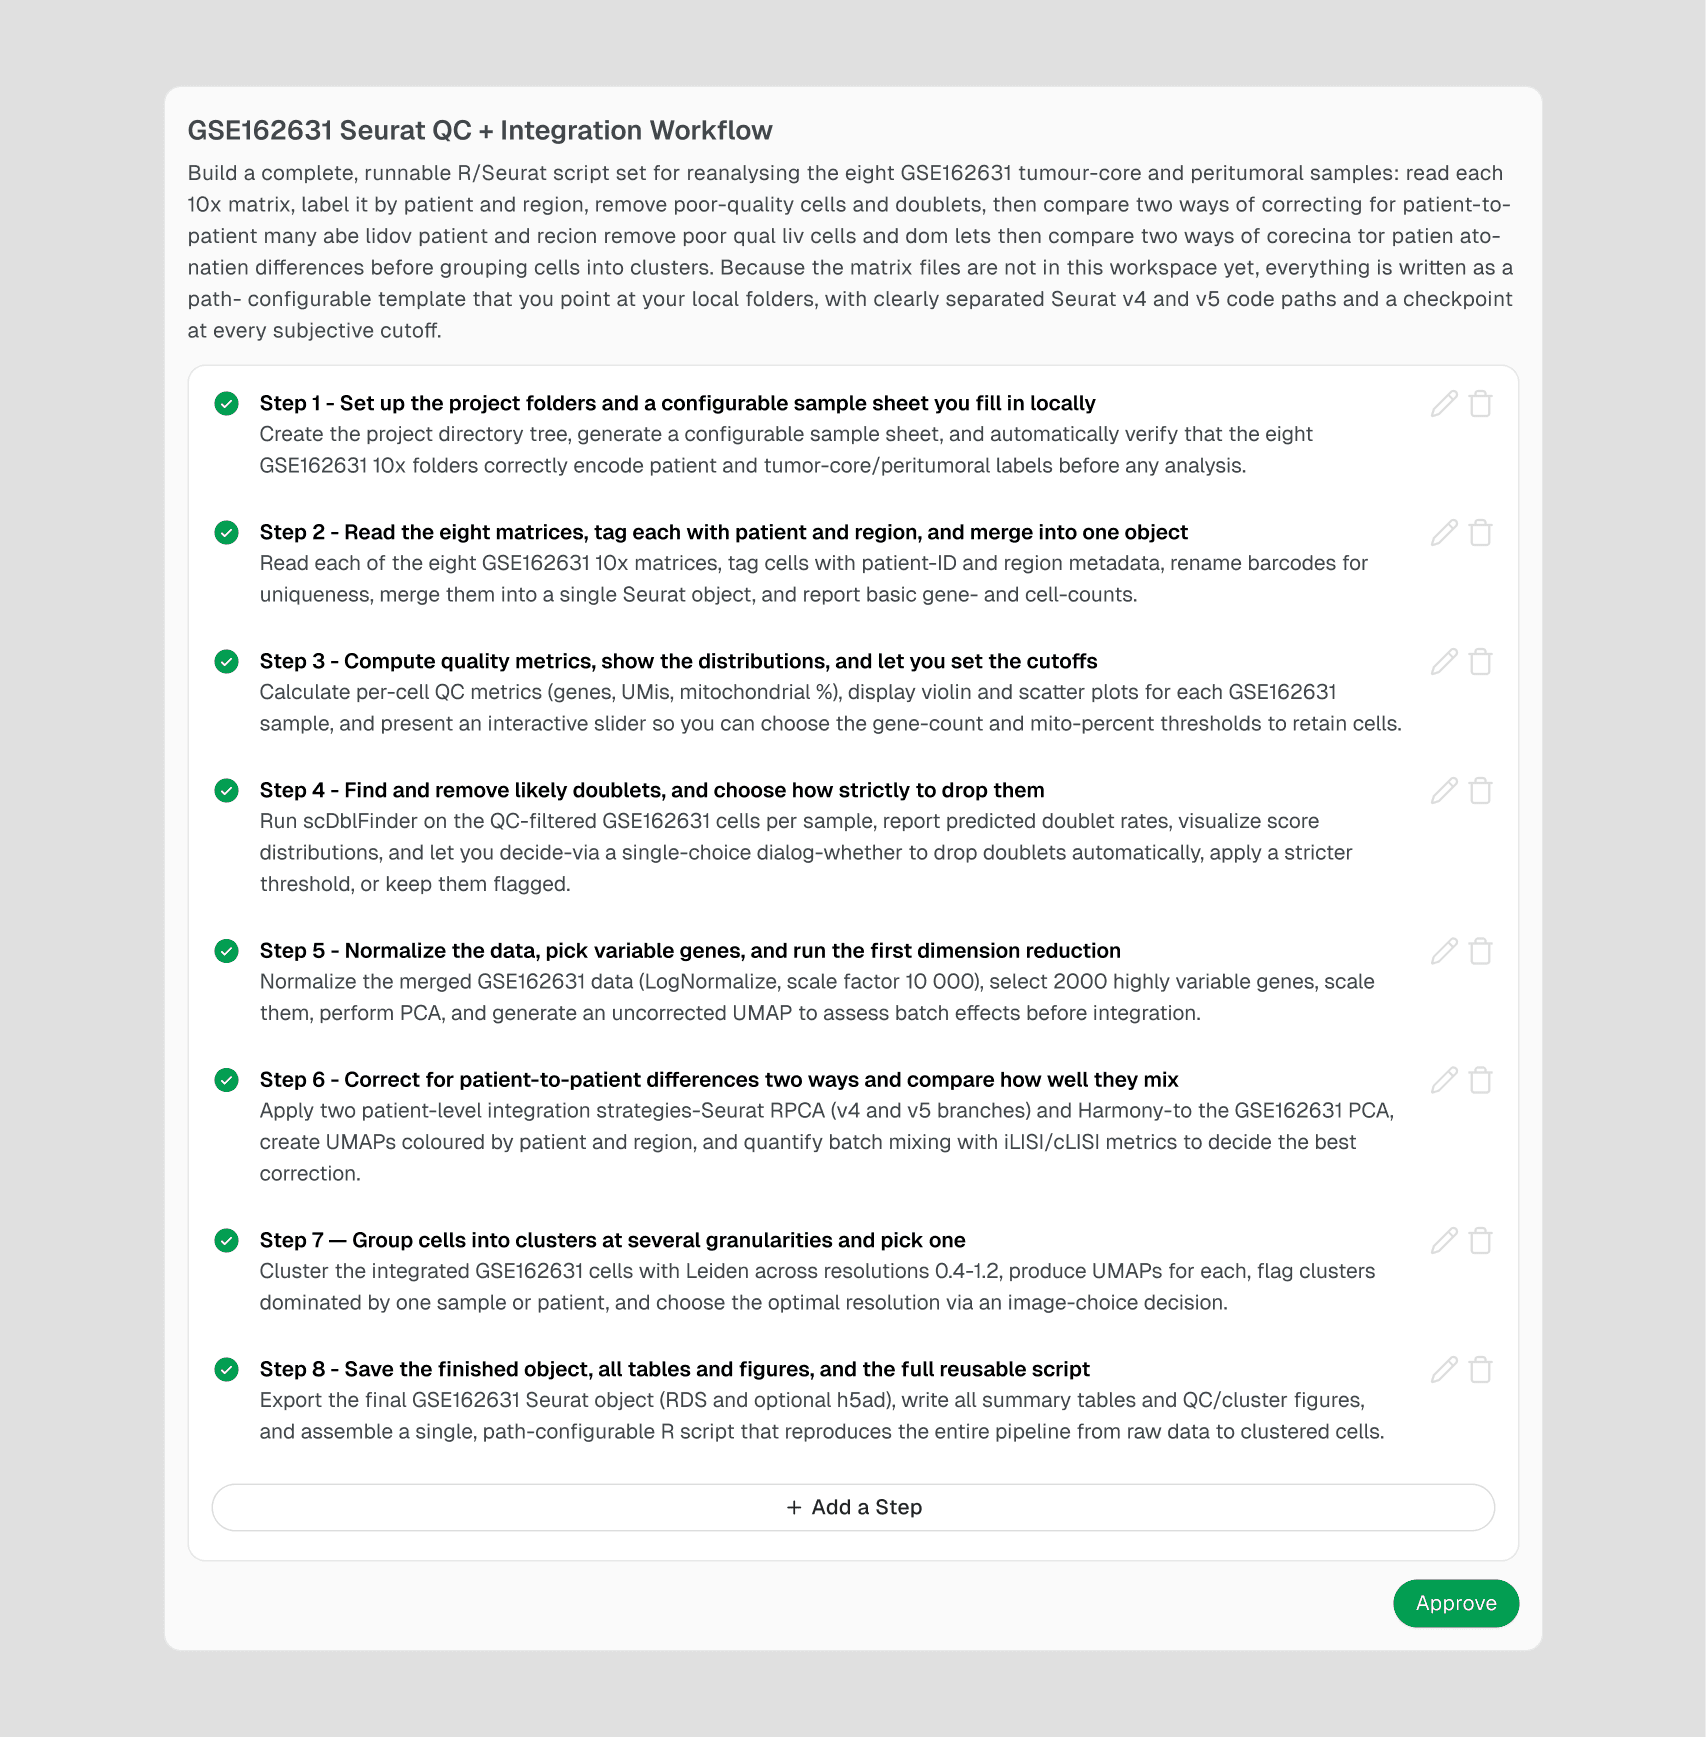
Drylab 把提示词变成八个有名称的步骤,从“建立项目文件夹和可配置的样本表”一直到“保存最终对象、所有表格和图,以及完整的可复用脚本”。逐条阅读;如果哪里不对,在任何计算开始之前,就在这里编辑或删除该步骤。
3. 批准,或按建议批准
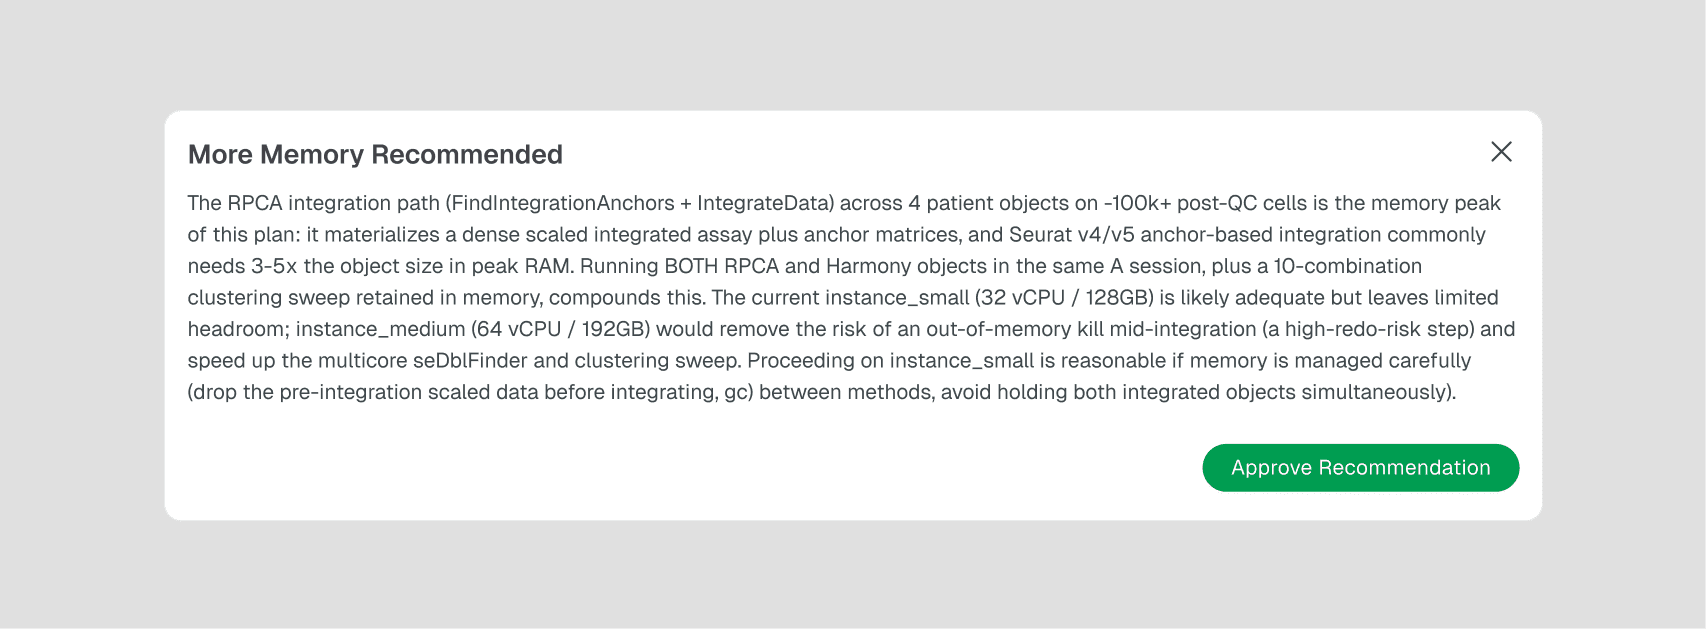
滚动到计划底部,Drylab 可能会在你批准之前提示资源方面的问题。这里显示的是“建议增加内存”,因为在一段会话中同时运行 RPCA 和 Harmony 整合非常耗内存。批准计划会按原样运行;使用 <推荐的实例> 批准则采用推荐的实例大小。(截图中是这张卡片的旧版本,当时按钮的文字是“Approve Recommendation”。)
4. 回答整合方法的澄清问题
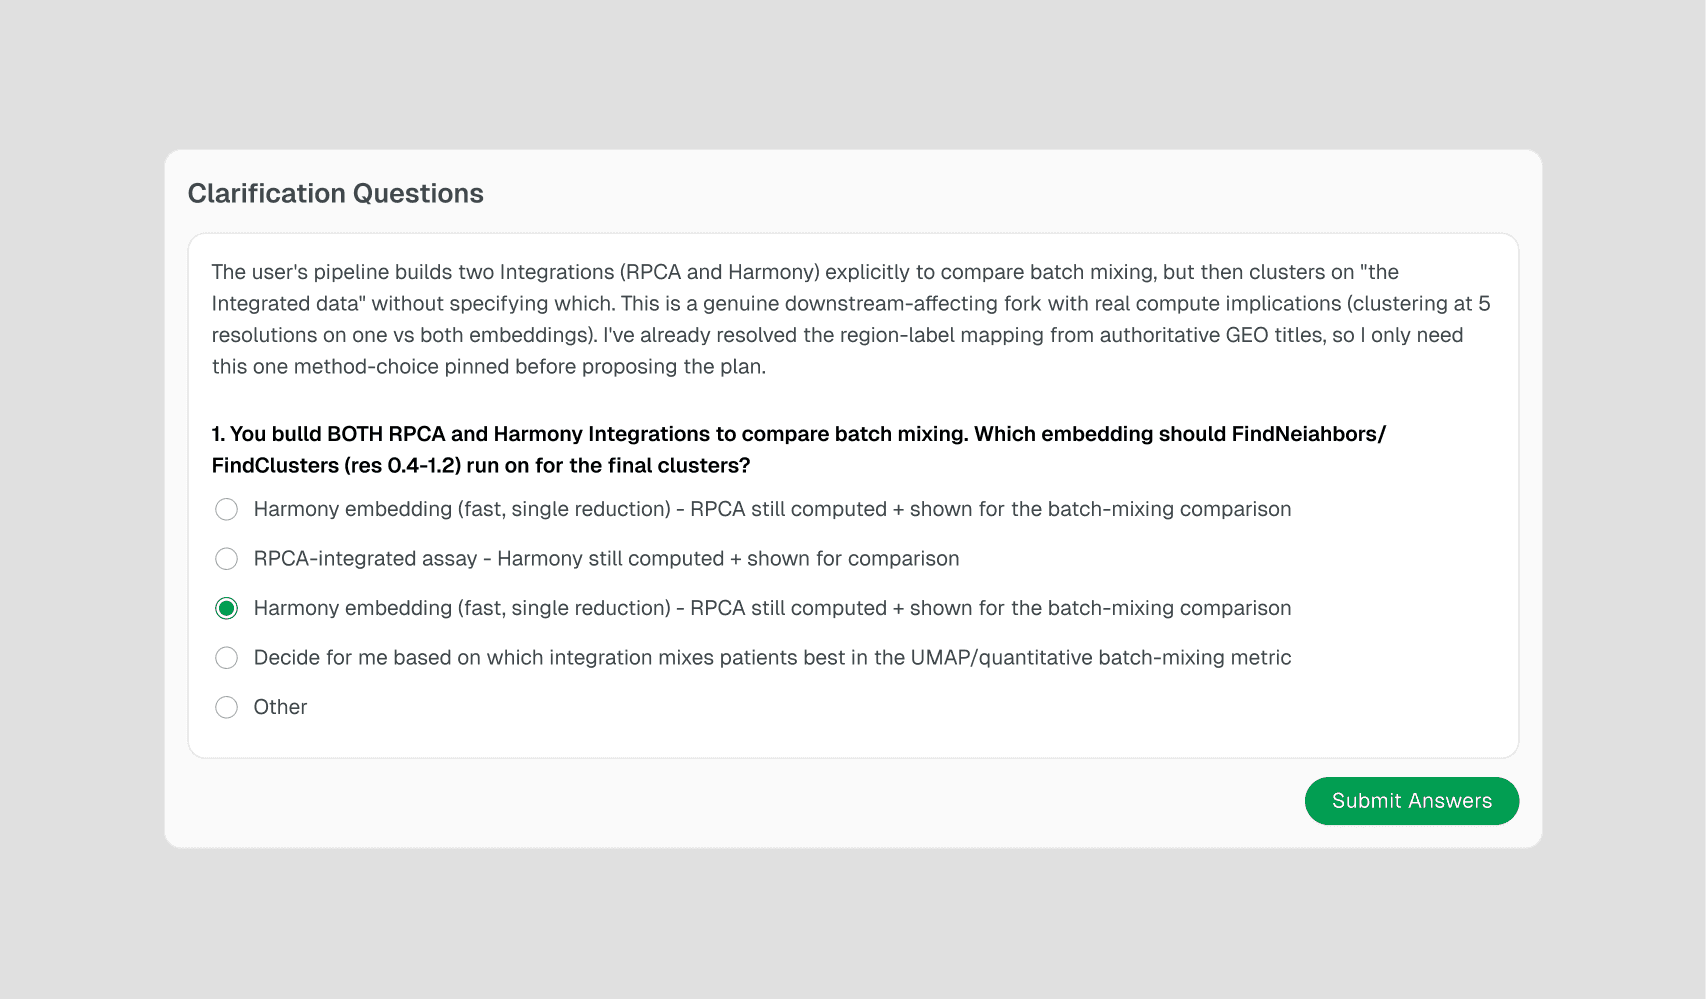
运行到一半,Drylab 遇到了一个真正的分岔:提示词要求同时运行 RPCA 和 Harmony 来比较批次混合效果,但没说聚类应该基于哪一个。它解释了两者的取舍,并给出四个选项。这里选择的是“两种都做聚类,并给我两张按样本统计的聚类表,方便直接比较”,这样能直接对比,而不是只相信 Drylab 的默认建议。
5. 根据实时数据拖动 QC 阈值
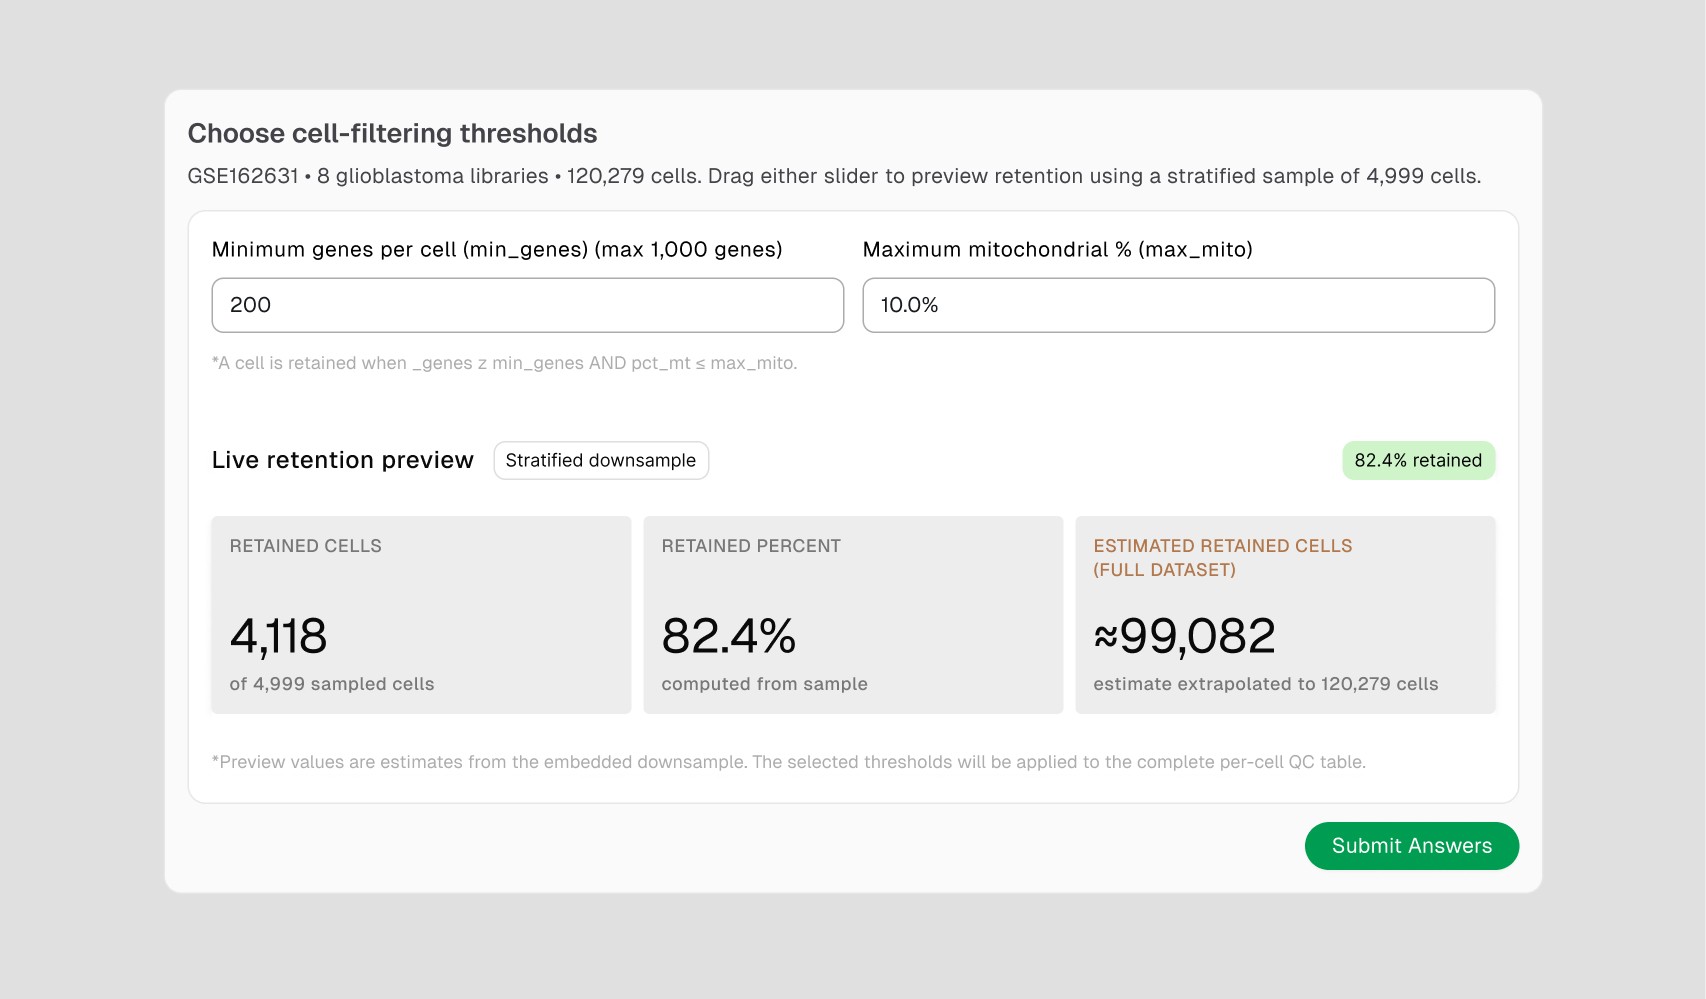
交互式 QC 检查点会预填你要求的默认值(200 个基因、10% 线粒体),并立即显示结果:按这些默认值,4,999 个细胞的分层抽样中保留了 82.4%,推算到全部 120,279 个细胞中约保留 99,082 个。确认之前拖动任一滑块,就能看到数字变化,不需要重新运行来看结果。
6. 比较 RPCA 和 Harmony,直观地选择分辨率
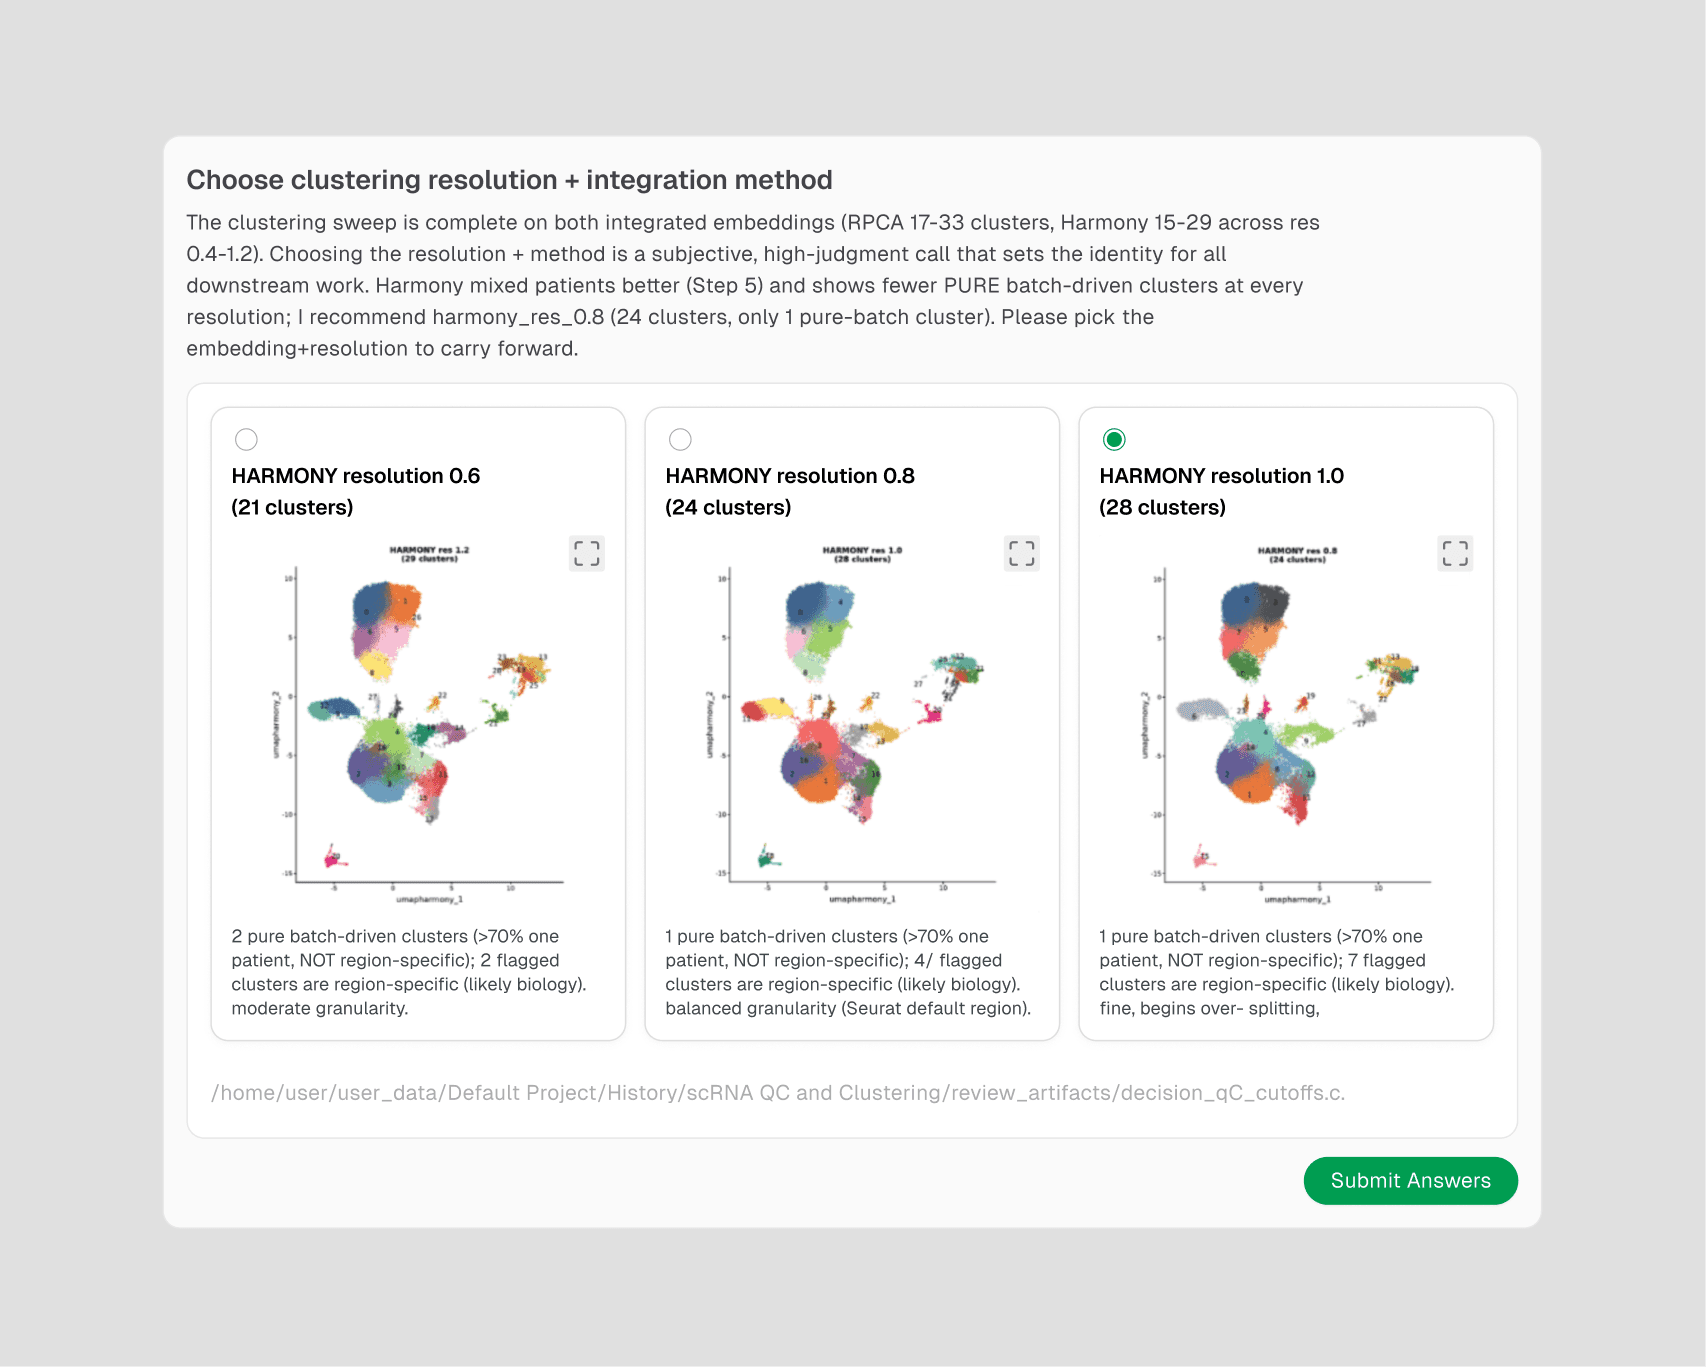
聚类扫描会对两种嵌入各跑五个分辨率(RPCA:17–33 个聚类;Harmony:15–29 个聚类)。Drylab 推荐 harmony_res_0.8:24 个聚类,只有 1 个纯批次聚类,是所有选项中最少的。它还列出了每个候选 UMAP,并在下方标出由批次驱动的聚类数,让你可以核对这个推荐,而不是只能相信它。
7. 继续之前检查溯源表
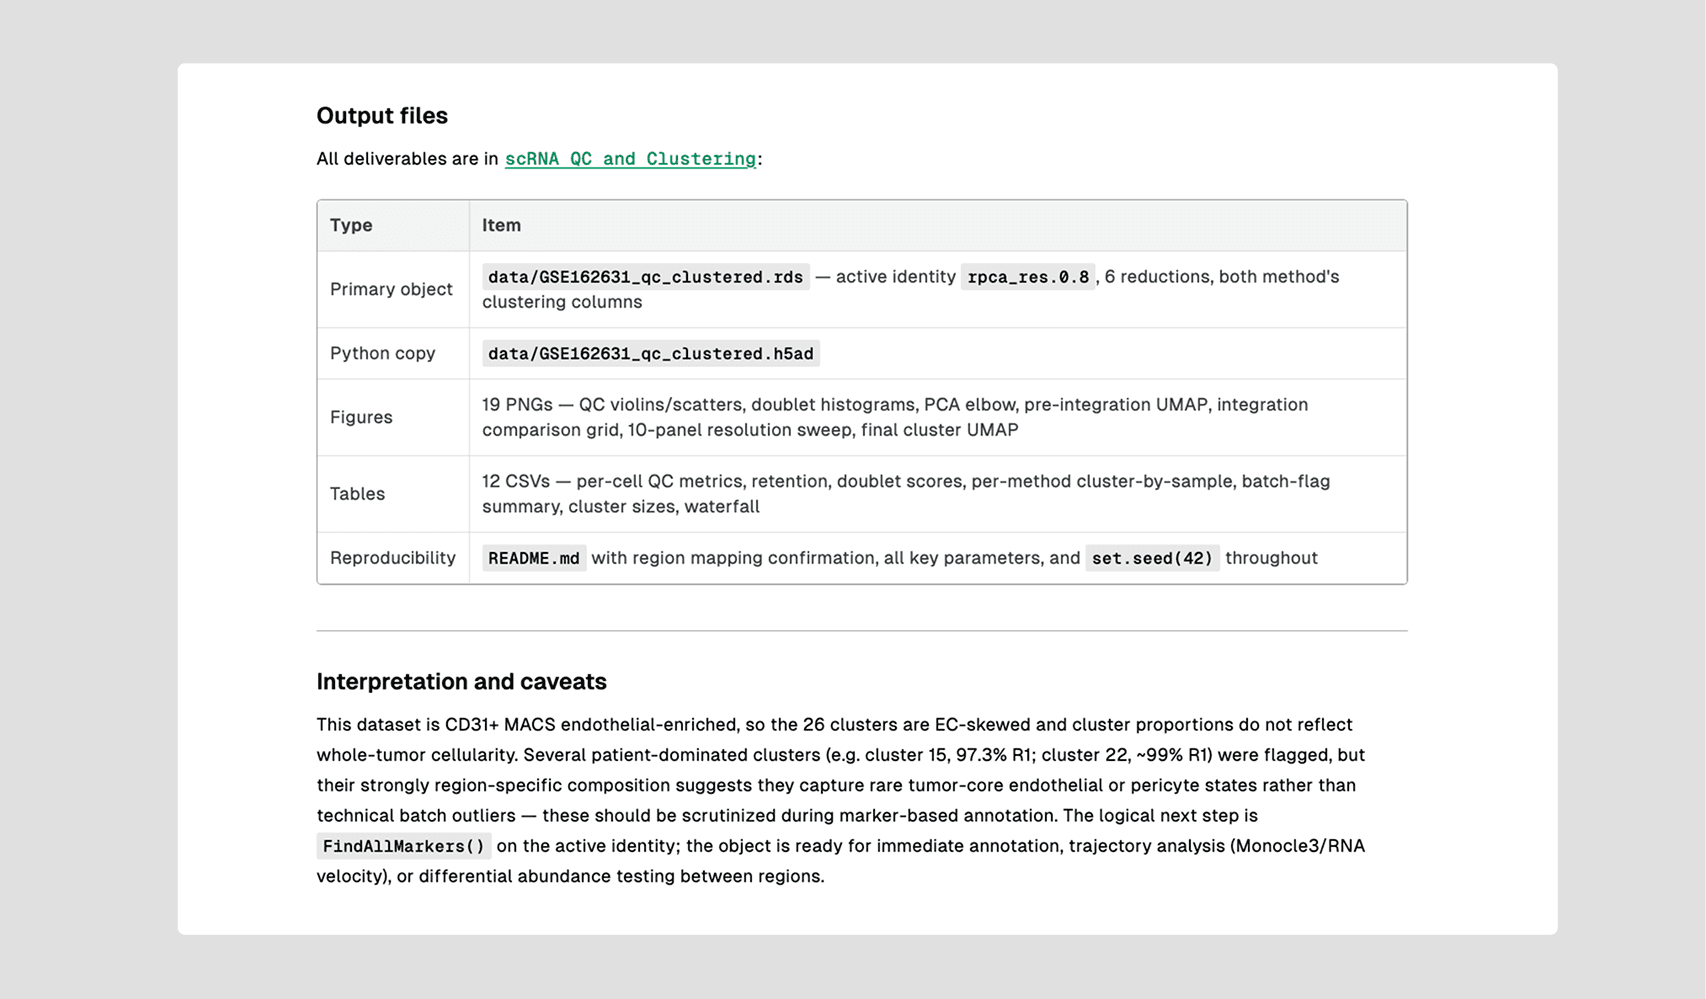
完成的步骤会准确报告生成了什么:主 .rds 对象(当前 identity 为 rpca_res_0.8,两种方法的聚类列都保留)、一份 Python 可读的 .h5ad 副本、19 张图、12 张表格,以及一份 README,记录了区域映射的确认、每个参数,以及全程使用的 set.seed(42)。这就是你可以交给合作者,或者六个月后回头核对的材料。
阶段 3:细胞类型注释
直接用刚构建好的聚类对象接着做注释。
1. 用你自己的标记基因接着运行 Cell-Type Annotation
在同一个对话中,用 @ 提及下一个工作流,并提供经典标记基因,而不是接受通用的默认值。这是实际使用的提示词:
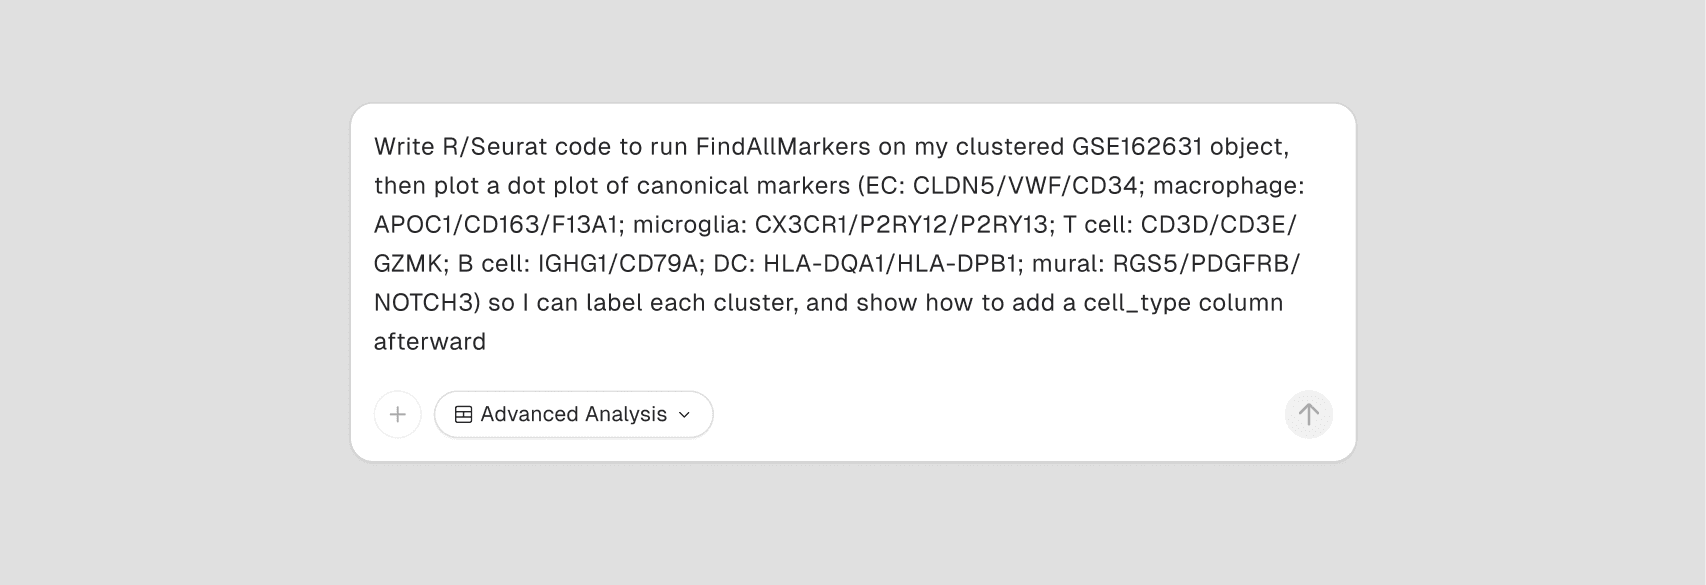
这组标记基因是针对该肿瘤微环境的(内皮细胞、巨噬细胞、小胶质细胞、T/B 细胞、DC、壁细胞)。换成你自己组织的标记基因即可,整体结构(FindAllMarkers → 点图 → 标注 → cell_type 列)保持不变。
2. 对照标记基因证据确认细胞类型标签
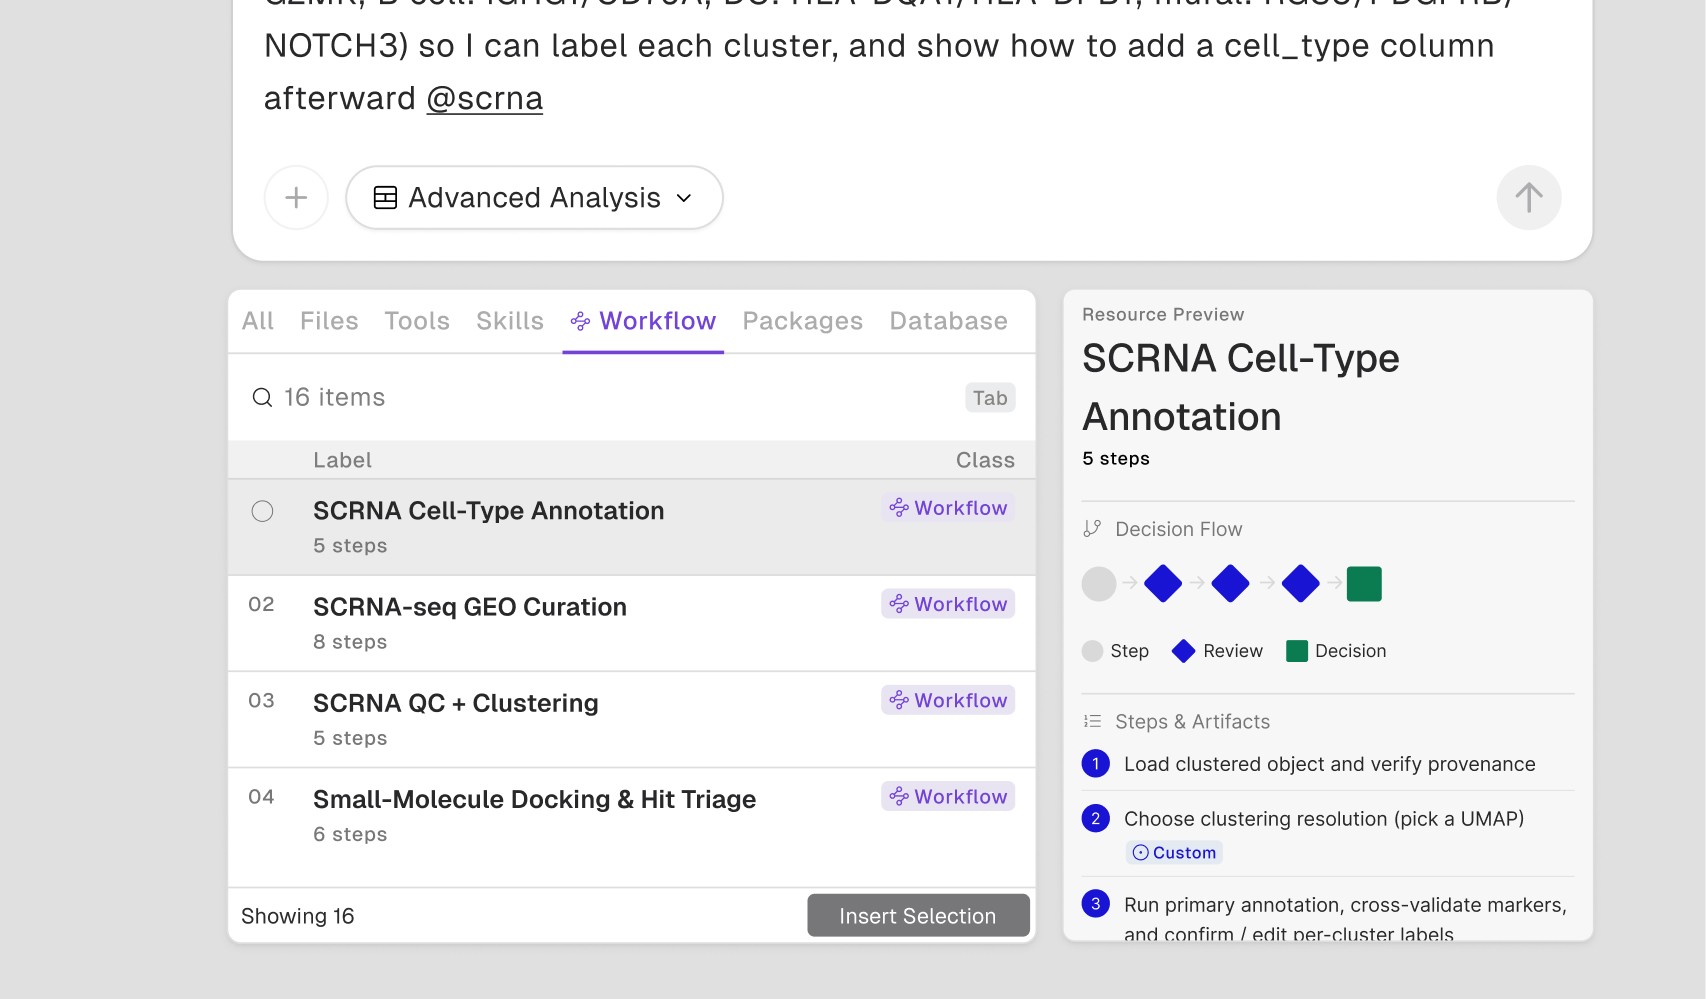
Cell-Type Annotation 自己的文档说明了会发生什么:“从候选 UMAP 中选择聚类分辨率,对照标记基因证据确认每个聚类的标签,决定哪些混合聚类要再细分,处理有歧义或低置信度的判定,并导出带溯源记录的注释对象。”第 3 步 Run primary annotation(运行初步注释)带有表格编辑标签:你会看到每个聚类生成的标签,可以修改任何与你的标记基因不符的标签。
3. 决定是否细分混合群体
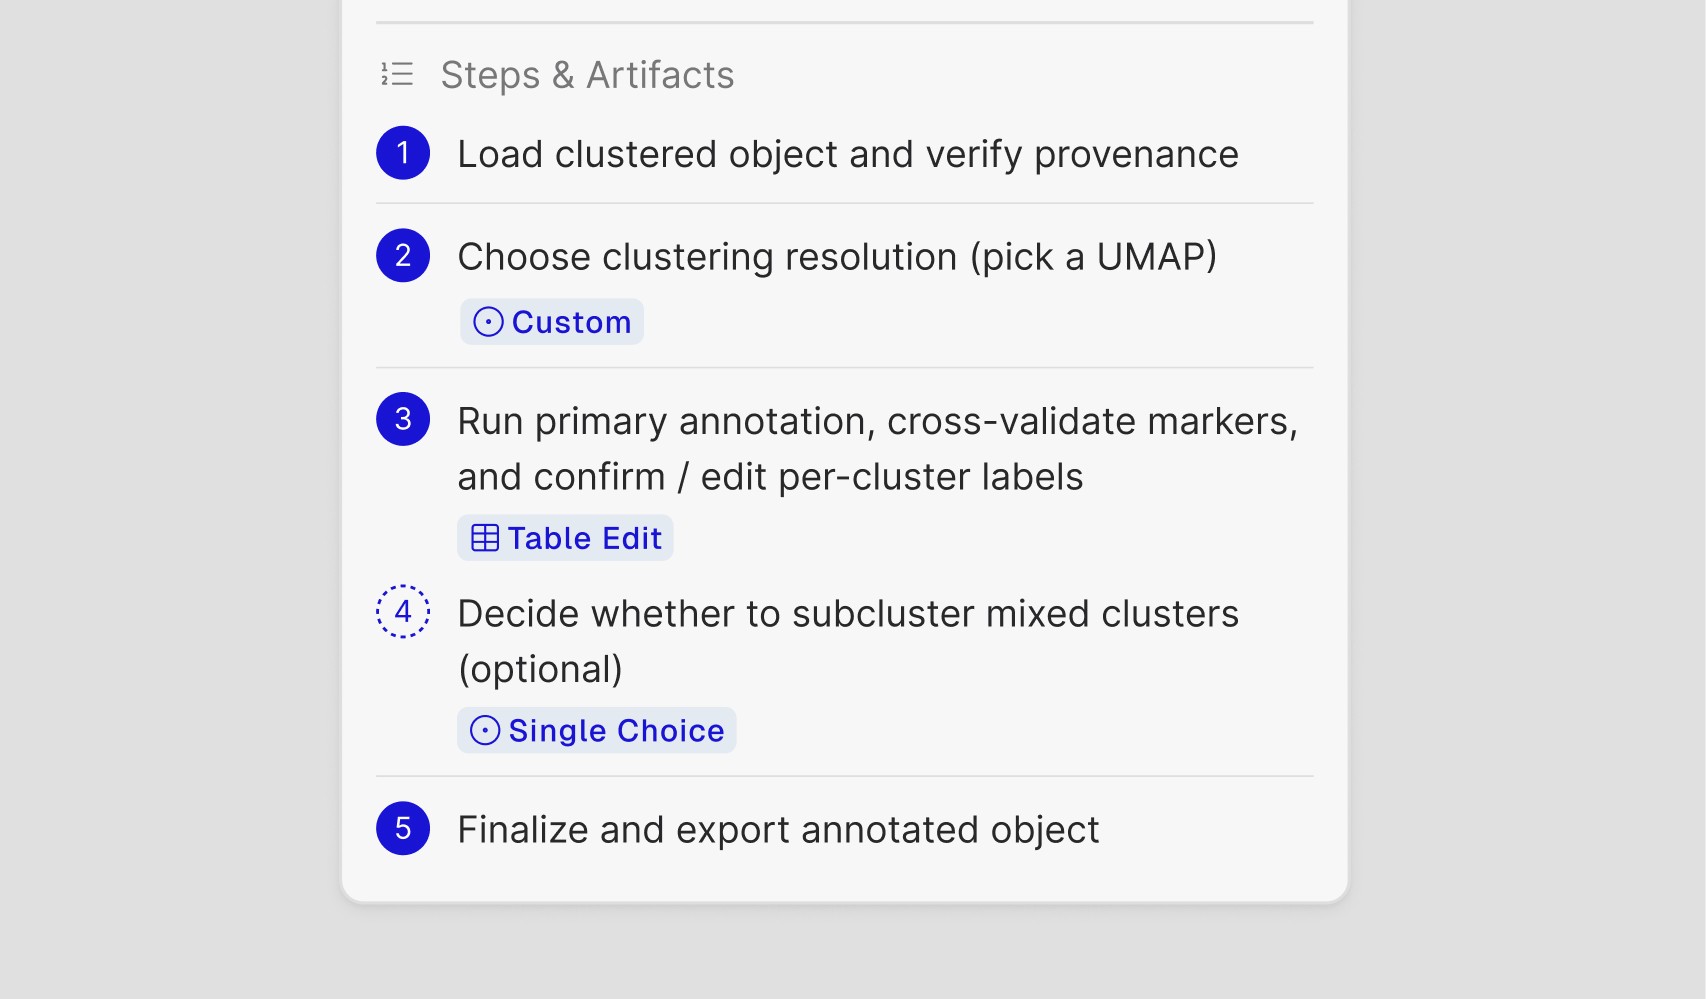
第 4 步明确是可选的,带有单选标签:如果某个聚类的标记信号是混合的(比如巨噬细胞和小胶质细胞的标记基因同时出现),由你决定是继续细分,还是把它当作一个群体。Drylab 不会悄悄地细分任何聚类:这个选项会出现,并等你做决定。